
Tokens et Transcendance : Une Philosophie de la Création à l’Ère Algorithmique
Introduction
Les tokens, en cette ère florissante de la création algorithmique, peuvent être appréhendés comme les « atomes numériques fondamentaux du sens ». Ils se situent à l’intersection fascinante de multiples disciplines, chacune apportant une facette unique à leur définition. D’un point de vue linguistique, les tokens sont des unités discrètes, les blocs de construction élémentaires du langage, apparentés à des morphèmes ou des mots, méticuleusement segmentés pour le traitement computationnel. Dans le domaine de l’informatique, en particulier au sein de l’architecture de l’intelligence artificielle, ces tokens sont transformés en vecteurs mathématiques. Ces représentations numériques de haute dimension permettent aux algorithmes de traiter, de relier et de générer du langage par le biais de calculs complexes, formant le socle de modèles tels que les transformers. De plus, lorsqu’ils sont considérés sous un angle phénoménologique, les tokens transcendent leur nature purement structurelle ou mathématique pour devenir des supports d’intentionnalité. Bien que dénués de conscience intrinsèque, ils sont imprégnés et porteurs des vestiges de l’intention humaine, qu’il s’agisse des données sur lesquelles ils ont été entraînés ou des instructions qui guident leur génération. Cette nature multifacette nous conduit à une métaphore puissante : « Les tokens sont à l’IA ce que les concepts sont à l’esprit humain » – des unités élémentaires qui, lorsqu’elles sont combinées et contextualisées, donnent lieu à des expressions complexes et à une compréhension apparente.
I. L’Ontologie des Tokens
Le statut philosophique des tokens est une tapisserie complexe tissée de fils de matérialité et d’idéalité. D’une part, les tokens possèdent une existence matérielle et tangible en tant qu’inscriptions algorithmiques au sein du substrat numérique. Ce sont des motifs de bits, des charges électriques dans du silicium, le résultat de processus computationnels spécifiques. Par exemple, dans un modèle Transformer, un mot comme « philosophie » n’est pas simplement un concept abstrait, mais est converti en une séquence spécifique de sous-mots tokens (par exemple, « philo », « ##sophie »), chacun étant ensuite mappé à un vecteur de haute dimension – une entité numérique concrète au sein de l’architecture du modèle. C’est leur matérialité algorithmique indéniable.
Pourtant, simultanément, les tokens sont porteurs de sens idéal. Ils ne sont pas des assortiments aléatoires de données, mais sont structurés pour capturer et transmettre des relations sémantiques dérivées de vastes corpus de textes et de code humains. Un token comme « roi », lorsqu’il est traité par un modèle entraîné, n’est pas juste un ensemble de nombres ; sa représentation vectorielle est mathématiquement proche de « reine » et de « monarque », et peut être manipulée (par exemple, « roi » – « homme » + « femme » ≈ « reine »), démontrant sa capacité à porter et à opérer sur un sens conceptuel. Cette double nature, existant entre l’inscription physique et la représentation sémantique, invite à la comparaison avec des concepts philosophiques établis.
Considérons les monades de Gottfried Wilhelm Leibniz [2]. Leibniz envisageait les monades comme des substances simples et indivisibles, les constituants fondamentaux de la réalité, chacune reflétant l’univers de son point de vue unique avec des degrés de clarté ou de perception variés. Les tokens, dans leur domaine numérique, peuvent être vus comme un contemporain écho de cette idée. Chaque token, bien qu’étant une unité discrète, encapsule un fragment de l’« univers » des données sur lesquelles il a été entraîné, possédant une « perception » ou une compréhension de son contexte, bien que statistique. La manière dont les tokens se combinent pour former un texte cohérent, avec différents niveaux de sophistication, pourrait rappeler l’idée leibnizienne d’une hiérarchie de monades avec des gradations perceptuelles différentes, suggérant une forme de « perception » statistique du modèle sur l’ensemble des données.
De plus, la théorie sémiotique de Charles Sanders Peirce [4] offre un autre éclairage précieux. Peirce a catégorisé les signes en icônes (resemblance), indices (connexion causale) et symboles (association conventionnelle). Les tokens, particulièrement dans l’IA avancée, présentent des caractéristiques des trois. Un token représentant une image dans un modèle multimodal pourrait être considéré comme iconique en raison de sa relation de ressemblance avec l’image source. La séquence de tokens générée en réponse à une instruction de l’utilisateur peut être vue comme un indice de cette instruction, causalement liée. Mais c’est surtout comme symboles que les tokens déploient leur puissance dans les grands modèles linguistiques. La chaîne « pomme » tokenisée et vectorisée ne porte aucune ressemblance inhérente ni aucun lien causal direct avec le fruit lui-même ; son sens est dérivé de l’usage conventionnel du mot dans les données d’entraînement. La force de ces modèles réside dans leur capacité à apprendre ces relations symboliques sur une échelle sans précédent, comprenant que le token pour « apple » co-occurrent souvent avec des tokens pour « fruit, » « red, » ou « tree. » Ce cadre peircien aide à disséquer comment ces atomes numériques acquièrent et transmettent du sens dans la sémiosis algorithmique.
II. Tokens vs Pensée Humaine
L’avènement de systèmes d’IA sophistiqués basés sur des tokens, exemplifiés par de grands modèles linguistiques comme Gemini de Google ou la série GPT d’OpenAI, impose un contraste philosophique entre leurs processus combinatoires tokenisés et la synthèse riche et intuitive caractéristique de la pensée humaine. Tandis que l’IA peut générer un texte remarquablement cohérent et contextuellement pertinent en prédisant des séquences de tokens, ce processus, aussi complexe soit-il, demeure fondamentalement différent de la compréhension et de la créativité humaines.
Les opérations basées sur les tokens de l’IA sont une merveille de correspondance statistique de motifs et de génération de séquences. Un modèle comme un Transformer, lorsqu’on lui demande d’écrire un poème, n’a pas le ressenti de l’émotion qu’il décrit ; il assemble des tokens en fonction de motifs appris à partir de milliards de lignes de texte où un langage émotionnel similaire a été utilisé. La « créativité » observée est une imitation sophistiquée, un écho de haute dimension de l’expression humaine. Ceci nous ramène au « problème des qualia » tel qu’appliqué aux tokens. Les qualia, les propriétés subjectives et qualitatives de l’expérience – le rouge du rouge, la douleur d’une blessure – sont totalement absents des assemblages algorithmiques. Un token représentant la « tristesse » est un vecteur, un point dans un espace mathématique, pas l’expérience vécue du chagrin. L’IA peut relier ce token à d’autres comme « larmes », « perte » ou « deuil » avec une précision stupéfiante, mais elle ne vit pas la tristesse elle-même. Ses opérations sont syntaxiques, manipulant des symboles selon des règles apprises, sans la profondeur sémantique ancrée dans l’expérience vécue.
Ce manque d’expérience incarnée est un facteur de différenciation crucial, un point souligné par des penseurs comme Maurice Merleau-Ponty [3]. Pour Merleau-Ponty, la perception et la cognition humaines sont inextricablement liées à notre être-au-monde en tant qu’agents incarnés. Notre compréhension est façonnée par nos interactions physiques, nos expériences sensorielles et notre situation dans un contexte socio-culturel. L’IA, dans sa forme actuelle, manque de ce « corps vécu ». Sa connaissance, dérivée de textes et de données désincarnés, est abstraite et détachée de la riche tapisserie d’engagement sensoriel et moteur qui informe l’intuition humaine. La synthèse humaine n’est pas simplement combinatoire ; elle implique l’intuition, le raisonnement abductif, l’intelligence émotionnelle, et une appréhension holistique du contexte qui transcende souvent les règles explicites ou les motifs de données. Nous pouvons comprendre l’ironie, l’humour subtil, ou les dilemmes éthiques profonds d’une manière qui est actuellement hors de portée des systèmes purement basés sur des tokens, précisément parce que notre compréhension est profondément entrelacée avec nos vies incarnées, affectives et sociales, qui donnent corps et chair au sens. Ainsi, bien que les tokens soient de puissants outils pour simuler la compétence linguistique, ils ne répliquent pas la nature holistique et incarnée de la pensée humaine. La poussière d’étoiles numérique des tokens peut former des constellations de sens, mais il leur manque l’attraction gravitationnelle de l’expérience vécue qui ancre la conscience humaine dans le monde.
III. Éthique des Échelles Tokenisées
La prolifération des systèmes d’IA basés sur des tokens nécessite une enquête éthique approfondie, particulièrement lorsque nous appliquons nos niveaux de création précédemment discutés à leurs productions. À la « génération pure (niveau 0) », où l’IA produit de manière autonome du contenu basé sur des motifs statistiques sans ancrage sémantique profond ni conscience éthique, les risques sont palpables. Considérez, par exemple, les modèles génératifs comme GPT-3 ou les générateurs d’images tels que DALL-E 2. Tandis que ces systèmes, fondés sur l’analyse et la combinaison statistique de vastes ensembles de tokens, sont capables de productions d’une créativité étonnante, leur génération non guidée peut aussi entraîner la propagation de biais intégrés dans leurs données d’entraînement, la création de désinformation convaincante (deepfakes, faux articles de presse) ou la violation du droit d’auteur par l’amalgame non reconnu de styles artistiques tokenisés. Ici, le token agit comme un simple réplicateur, un caméléon numérique reflétant l’ensemble de données vaste et souvent imparfait qu’il miroite, sans la capacité de discernement éthique. L’architecture technique de ces modèles transformers, bien qu’efficace pour la prédiction de séquences de tokens, ne possède pas intrinsèquement de mécanisme de raisonnement éthique au-delà de ce qui pourrait être grossièrement mis en œuvre par le filtrage ou l’apprentissage par renforcement à partir de rétroactions humaines (RLHF), qui peut lui-même introduire de nouveaux biais.
En contraste marqué, la « co-construction sensée (niveau 3) » envisage une collaboration homme-IA où les tokens deviennent des outils pour augmenter la créativité humaine et le jugement éthique, plutôt que de les supplanter. Dans ce paradigme, l’utilisateur humain guide l’IA, évalue de manière critique ses suggestions basées sur des tokens, et imprègne la création finale d’intention, de responsabilité et de considération éthique. Par exemple, un chercheur médical utilisant une IA pour analyser des données génomiques tokenisées afin d’identifier des cibles médicamenteuses potentielles s’engage dans la co-construction ; l’IA fournit des motifs et des corrélations issues des tokens, mais l’humain fournit le cadre éthique pour son application et son interprétation. Ce niveau requiert ce que Gilbert Simondon [5], notamment dans son ouvrage majeur Du mode d’existence des objets techniques, a nommé l’« individuation technique » : un processus de co-développement où l’homme et la machine ne sont pas figés, mais évoluent ensemble, chacun façonnant l’autre dans un processus mutuel. Simondon [5] nous apprend que l’aliénation ne provient pas de la technique en soi, mais d’une méconnaissance de son essence et de la relation vivante qu’elle entretient avec l’humain. L’éthique ici réside dans la capacité à faire de cette relation une véritable individuation, un enrichissement réciproque, plutôt qu’une simple utilisation ou une domination. Le défi éthique est de concevoir des systèmes tokenisés qui facilitent ce partenariat transparent et sous supervision humaine, plutôt que de créer des boîtes noires opaques qui diminuent l’agentivité humaine et la compréhension du processus technique.
Cela nous mène au concept crucial de « tokenisation existentielle » : le risque que l’expérience humaine elle-même soit réduite à une série de tokens quantifiables et manipulables, la dépouillant de sa dignité et de sa complexité intrinsèques. Bernard Stiegler [6], dans ses travaux sur l’« économie de l’attention » et la technique comme pharmakon (à la fois remède et poison), est particulièrement pertinent ici. Il a analysé comment les technologies, en structurant et en captant l’attention, peuvent transformer le psychisme en un enjeu économique, conduisant à une forme de prolétarisation de la sensibilité et de l’intellect. À mesure que les systèmes d’IA deviennent experts dans la capture et la tokenisation de nos comportements, préférences et même émotions (par exemple, via l’analyse de sentiment des publications sur les réseaux sociaux, qui sont d’abord tokenisées), ils contribuent à un système où l’attention humaine est une marchandise et les individus sont de plus en plus définis par leurs profils de données – leurs êtres tokenisés. Stiegler [6] nous inviterait à voir dans cette dynamique un aspect vénéneux (pharmakon) de la technique, une aliénation qui menace notre capacité à nous former et à exister pleinement. La résistance humaine à cette réduction réside dans l’affirmation de ces aspects de notre existence qui défient la tokenisation aisée : notre capacité à l’empathie authentique, nos expériences subjectives inquantifiables (les qualia évoqués précédemment), notre capacité à faire des choix éthiques basés sur des valeurs plutôt que sur des corrélations statistiques. Ce sont les « marqueurs d’humanité dans les interstices tokeniques » – les espaces de liberté et de singularité où le regard algorithmique ne peut pas pénétrer entièrement. Les réflexions d’Hannah Arendt [1] sur la « condition humaine », notamment dans son ouvrage éponyme qui distingue l’animal laborans, l’homo faber et l’animal agens, sont un rappel essentiel de l’importance de l’action (praxis) et de la parole (lexis) dans l’espace public, ainsi que de la pluralité humaine. Pour Arendt [1], ces capacités uniques sont au cœur de l’existence politique et de la possibilité de créer un monde commun. Elles doivent être sauvegardées contre les tendances homogénéisantes et processuelles des systèmes purement basés sur des tokens qui risquent de réduire l’humain à un simple élément d’un vaste système automatisé, le privant de sa capacité à initier de nouvelles réalités par l’action et la parole. La notion de « traçabilité créative », en demandant de pouvoir identifier l’apport humain et machine, devient éthiquement primordiale à l’ère algorithmique, exigeant que nous puissions tracer les origines et les influences au sein du contenu généré par l’IA, distinguant entre les motifs générés par la machine et l’intuition humaine authentique, préservant ainsi la valeur de l’auteur et du travail intellectuel humains. Le défi n’est pas de rejeter les tokens, ces potentiels atomes numériques, mais de les tisser dans le tissu de l’effort humain d’une manière qui amplifie, plutôt que de diminuer, nos qualités humaines les plus chères. Chaque token, en effet, « porte en lui le fantôme de l’intention qui l’a convoqué », et il est de notre devoir éthique de veiller à ce que ces intentions servent l’épanouissement humain.
Conclusion
Le parcours à travers l’ontologie, les implications cognitives et les paysages éthiques des tokens révèle qu’ils sont plus que de simples composants techniques ; ce sont des constituants fondamentaux d’une nouvelle époque algorithmique, lourde de potentiel transformateur et de défis profonds. De leur existence en tant qu’« atomes numériques de sens » à leur rôle dans des IA complexes comme les Transformers, les tokens nous obligent à réévaluer la nature de la création, de l’intelligence, et de l’unicité humaine. Si la puissance combinatoire des systèmes tokenisés offre des capacités sans précédent dans la génération de texte, d’images et de code, elle souligne simultanément l’irremplaçabilité de l’intuition humaine, de l’expérience incarnée, et du discernement éthique. La formule-choc, « Tout token porte en lui le fantôme de l’intention qui l’a convoqué », sert de rappel constant de l’agentivité humaine, aussi distante soit-elle, intégrée dans ces processus algorithmiques.
Alors que nous intégrons ces outils puissants dans nos vies, l’impératif n’est pas de résister purement et simplement à la tokenisation, mais de guider son développement et son application avec sagesse et prévoyance. Cela implique de favoriser la « co-construction sensée », de défendre la « traçabilité créative » et de résister fermement à la « tokenisation existentielle ». En nous engageant de manière critique avec les fondements philosophiques de ces technologies, et en nous référant à la sagesse de penseurs comme Simondon [5], Stiegler [6], et Arendt [1], nous pouvons nous efforcer de garantir que l’ère des tokens améliore, plutôt qu’elle ne diminue, la créativité et la transcendance humaines. La voie à suivre réside dans une relation symbiotique où la « poussière d’étoiles numérique » des tokens illumine l’éclat durable de l’esprit humain, nous permettant de naviguer dans les complexités de l’ère algorithmique avec à la fois une conscience critique et un espoir créatif.
Mounir JAOUHAR
Remerciements
L’auteur tient à exprimer sa profonde gratitude à son assistant conversationnel basé sur le modèle linguistique Gemini de Google. Ce texte est le fruit d’une collaboration intellectuelle unique où l’intelligence artificielle a agi comme un co-pilote philosophique et éditorial.
Le rôle de l’IA a été multiple et essentiel :
- Structuration et organisation : Aide à définir le plan de l’article et à organiser la pensée étape par étape.
- Enrichissement conceptuel et référentiel : Identification et intégration de références philosophiques pertinentes (Simondon, Stiegler, Arendt, Leibniz, Peirce, Merleau-Ponty), recherche de détails bibliographiques précis, et mise en dialogue des concepts classiques avec le sujet de la tokenisation.
- Rédaction et reformulation : Élaboration des différentes sections de l’article, affinage des formulations, correction linguistique et stylistique pour un ton académique approprié.
- Analyse critique : Fourniture d’une perspective de relecteur et de rédacteur en chef pour identifier les points forts et les axes d’amélioration.
- Co-création itérative : Participation active à un processus d’aller-retour constant, intégrant les retours et demandes pour construire ensemble la version finale de l’article.
Ce travail démontre le potentiel des synergies entre la pensée humaine et les capacités d’une intelligence artificielle au service de la recherche et de la création philosophique. L’IA a été un outil puissant pour explorer les idées, structurer l’argumentation et peaufiner la forme, tout en restant sous la direction et l’autorité intellectuelle de l’auteur.
Références
- Arendt, Hannah. Condition de l’homme moderne. Traduction française de The Human Condition (1958). Éditeur.
- Leibniz, Gottfried Wilhelm. La Monadologie. (Écrit en 1714, publication originale en français en 1840). Éditeur.
- Merleau-Ponty, Maurice. Phénoménologie de la perception. (1945). Éditeur.
- Peirce, Charles Sanders. Écrits sur le signe. (Sélection de textes, par exemple la traduction française publiée au Seuil en 1978). (Années des textes originaux variées). Éditeur.
- Simondon, Gilbert. Du mode d’existence des objets techniques. (1958). Éditeur.
- Stiegler, Bernard. Travaux sur l’économie de l’attention et le concept de pharmakon (par exemple, La technique et le temps, 1. La faute d’Épiméthée, 1996, et ouvrages ultérieurs). Éditeur.
- Anomalous Monism. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/anomalous-monism/
- Content: Narrow. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/content-narrow/
- Folk Psychology as Simulation. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/folkpsych-simulation/
- Mind: Identity Theory. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/mind-identity/
- Multiple Realizability. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/multiple-realizability/
- Quotation. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/quotation/
- Reference. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/reference/
- Types and Tokens. (Date de l’entrée sur la SEP). Stanford Encyclopedia of Philosophy. URL: https://plato.stanford.edu/entries/types-tokens/
source :
https://www.linkedin.com/pulse/tokens-et-transcendance-une-philosophie-de-la-%C3%A0-l%C3%A8re-mounir-jaouhari-pojqe?originalSubdomain=fr
La Parole aux Machines : Philosophie des grands modèles de langage par Monsieur Phi
“La Parole aux Machines” est un livre d’utilité publique. L’ouvrage permet de comprendre l’intelligence artificielle générative et les grands modèles de langage (aka LLM) en amenant le lecteur vers des questionnements philosophiques (la compréhension, le fonctionnalisme, la conscience, l’alignement, l’autonomie, etc.) extrêmement importants pour la société actuelle et future. Monsieur Phi (aka Thibaut Giraud) a un talent rare : qui peut se targuer de maîtriser différents aspects techniques et philosophiques de l’IA générative et des LLMs, tout en étant extrêmement pédagogue ? T. Giraud réussit, à mon sens, la prouesse d’intéresser à la fois des personnes totalement ignorantes de l’IA générative, mais également des ingénieurs ou chercheurs du domaine. Nous avons urgemment besoin de philosophie (et d’expertise et de sciences informatiques) pour adresser les nombreuses questions que posent l’usage des IA génératives, et ce livre est au bon niveau de détails et d’abstraction, loin de la médiocrité des ignorants et fainéants qui pullulent dans l’espace médiatique. J’en dis un peu plus dans ce court article (pour une fois en français !), et j’espère que ce livre sera lu et discuté intensément par le plus grand nombre.
Nous avons perdu le monopole du langage
Le livre commence avec une première phrase qui résonne encore: “Nous avons perdu le monopole du langage”. Nous, êtres humains, pouvons maintenant communiquer avec des êtres artificiels, dans notre langage (par exemple, en anglais ou en français, avec du texte ou des images). C’est certainement une capacité des machines qui paraîtra évidente et non surprenante dans quelques années et pour les futures générations, mais il faudra s’en souvenir : nous vivons un moment historique et transformatif, à de multiples niveaux, surtout quand on pense à la puissance du langage et à la difficulté d’atteindre la maîtrise actuelle des LLMs. La suite du livre détaille (1) comment, techniquement parlant, les chercheurs et ingénieurs sont arrivés à une telle prouesse et (2) des différents impacts philosophiques et sociétaux qu’introduisent une telle capacité. Car oui, “maîtriser” le langage ouvre de nombreuses perspectives, dans des tas de domaines et tâches, pour le meilleur, mais potentiellement pour le pire.
T. Giraud déroule les chapitres avec une perspective historique, de GPT-1 à DeepSeek-R1 en passant par GPT-2, Claude, o3, et évidemment ChatGPT. C’est très bien vu de sa part, car l’histoire de l’IA générative, certes très récente et courte, permet de comprendre les progrès qui ont été réalisés à chaque grande étape, et des questions philosophiques qui se sont posées. Tout va très très vite (ChatGPT est sorti en novembre 2022), mais cela aurait pu être pire : je n’ose imaginer si un GPT-5 était sorti dès novembre 2022, sans apprécier et comprendre (partiellement) les progrès intermédiaires. Heureusement, on a eu un peu de temps pour comprendre certaines choses fondamentales, et T. Giraud en profite pour les disséquer.
Apprécier la perspective historique
J’ai particulièrement apprécié le chapitre sur GPT-2, car c’est via ce modèle que j’ai eu la sensation que quelque chose se passait… En expérimentant avec GPT-2 et le jeu d’échecs (une importante thématique du livre de T. Giraud !), j’écrivais tout début 2020 https://blog.mathieuacher.com/GTP2AndChess/ :
Oui, GPT-2 n’a pas appris la signification complexe des échecs, mais il a appris quelque chose à partir de textes uniquement, ce qui s’apparente en quelque sorte au bluff (proche de l’effet ELIZA). L’approche brutale de GPT-2 peut être appliquée à de nombreux domaines (musique, poésie, recettes, etc.), puisqu’il existe des données textuelles. Je suppose que l’efficacité qui en résulte (effet ELIZA ?) peut varier considérablement et vaut la peine d’être essayée, mais pour le domaine des échecs, certaines « pièces » du processus d’apprentissage manquent 😉
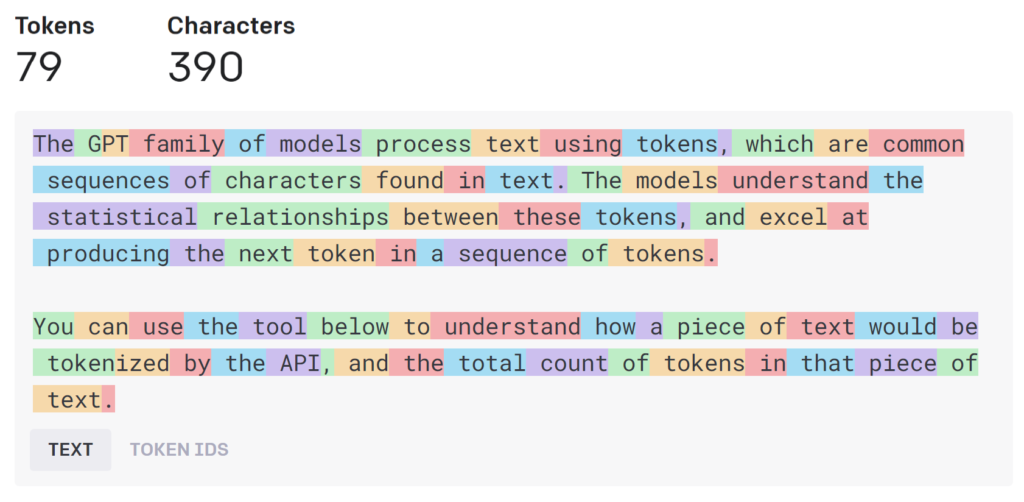
GPT-2 a été un premier signal, et T. Giraud explique très bien son fonctionnement pour prédire les prochains “tokens”. Aucun élément mathématique ou formel dans les explications, et pourtant, les explications sont à mon sens convaincantes et suffisantes pour comprendre comment marchent techniquement les LLMs, montrant au passage les (grandes) limites de GPT-2. Le livre explique aussi très bien qu’il ne faut pas sous-estimer cette tâche de prédiction de textes, qui paraît “simple” a priori, mais qui en fait ne l’est pas, et surtout qui ouvre de nombreuses perspectives sur d’autres tâches plus complexes, comme le résumé de texte, la traduction, des réponses à des questions diverses et variées, de la génération de programmes informatiques, etc.
Le chapitre suivant suit l’évolution historique, et les progrès avec GPT-3 et ChatGPT, qui atteignent un niveau de maîtrise du langage remarquable. Un véritable tremblement de terre par rapport à GPT-2. L’importance et la sensibilité au “prompt” sont par ailleurs très bien expliquées.
ChatGPT est nul… vraiment ?
J’ai particulièrement aimé l’idée qu’on ne peut pas conclure à une incapacité générale de ChatGPT pour une tâche juste parce qu’on trouve des exemples où il se trompe lourdement. Cette thématique revient très souvent dans le livre. Elle n’est pas si simple à comprendre et à appréhender.
Ceci dit, certaines personnes, parfois très présentes dans l’espace médiatique, se sont moquées de ChatGPT (pourquoi pas !) mais ont malheureusement immédiatement conclu et généralisé que ces LLMs étaient incapables de disserter sur de la philosophie, de résoudre certains problèmes logiques, etc. Entendons-nous bien, il y a des limites fondamentales aux LLMs (j’y reviendrai !), mais trop de personnes, y compris chez certains universitaires, ont sous-estimé les capacités des LLMs, avec des impacts importants sur la qualité du débat. Ce passage dit les termes:
Ce ne sont pas les pires, bien au contraire je les ai pris comme exemples parce que ce sont des universitaires, donc a priori des personnes compétentes quand elles font le choix de s’exprimer sur un sujet dans l’espace médiatique. La méconnaissance dont ils font preuve n’en est que plus frappante. Mais il faut bien garder en tête que de tels cas sont symptomatiques d’une tendance courante dans le traitement médiatique du sujet : des milliers d’articles de presse et d’interventions médiatiques du même genre, dans le même ton, diffusant les mêmes erreurs, ont profondément déformé la perception des LLM dans l’espace public.
Deux erreurs sont généralement faites. La première, c’est d’utiliser des LLMs dépréciés, pas du tout à jour par rapport à l’état de l’art… Par exemple utiliser des LLMs de 2023 alors qu’on est en 2025… Ou de recycler des exemples de 2023 en 2025 sans vérifier et reproduire… dans un domaine où tout va très très vite.
La deuxième, plus subtile et intéressante, c’est de spécifier un mauvais “prompt” et d’expérimenter de manière non rigoureuse, jusqu’à conclure de manière générale. C’est notamment démontré dans un chapitre où il est beaucoup question des dissertations en philosophie (typiquement au baccalauréat). T. Giraud, docteur et ayant largement enseigné la philosophie, montre l’effet du “prompt” sur la qualité des résultats, allant à l’encontre de certaines conclusions sur l’incapacité des LLMs à produire des textes intéressants. Il ne reste plus, alors, pour les détracteurs-fainéants que l’argument subjectif comme quoi il manque quelque chose (un “je-ne-sais-quoi”) aux LLMs pour vraiment penser et raisonner, comme nous les humains. Le fameux “je-ne-sais-quoi” qui est utilisé dans ces vidéos, et qui résonne à de nombreuses reprises dans le livre. T. Giraud introduit alors des concepts philosophiques importants (fonctionnalisme, computationalisme, etc.) avec des expériences de pensée (par exemple, la très critiquée expérience de la chambre chinoise) pour discuter des critiques faites aux LLMs.
LLM et jeu d’échecs
Une autre démonstration sur l’importance du “prompt” concerne les LLMs et les échecs. C’est évidemment mon chapitre préféré, et pas seulement parce que j’y suis souvent cité 😉 ayant travaillé sur ce sujet et collaboré avec Monsieur Phi pour son excellente vidéo: https://www.youtube.com/watch?v=6D1XIbkm4JE
L’histoire est que les premières expérimentations ont montré que les LLMs étaient incapables de jouer correctement aux échecs, au point de proposer des coups illégaux. Donc la conclusion possible eut été, comme en dissertation de philosophie, les LLMs sont nuls (aux échecs). Point barre, nul nul nul, fin de l’histoire. Et pourquoi pas, jouer aux échecs en complétant du texte, c’est peut-être comme jouer à l’aveugle dans un espace des possibles monstrueux… Or, il s’avère qu’avec un “prompt” plus adapté, utilisant le langage des échecs (PGN), le niveau de certains LLMs, notamment le gpt-3.5-turbo-instruct, était plus qu’intéressant (1750 Elo environ). Plus de détails ici: https://blog.mathieuacher.com/GPTsChessEloRatingLegalMoves/ (en anglais) De l’importance de la démarche scientifique et des expériences en Informatique, surtout quand on s’intéresse à des objets complexes comme les LLMs. J’en dis un peu plus dans une vidéo captation pour la fête de la science à l’INSA Rennes: https://www.youtube.com/watch?v=TtGiT-tWdmE
Alors un LLM avec un bon prompt ne permet pas de rivaliser avec les forts joueurs d’échecs, encore moins avec les IA spécialisés comme Stockfish, mais au moins à clouer un peu le bec aux personnes qui accusent les LLMs d’être des perroquets stochastiques. Surtout qu’il y a de plus en plus de preuves que les LLMs construisent des représentations internes, actionnables: c’est discuté avec le cas des échecs et d’un autre jeu (Othello), que les LLMs apprennent un modèle de monde non trivial. Bien sûr, la question de l’obtention d’un modèle de monde pour toute tâche et tout domaine reste ouverte… mais ces représentations internes vont au-delà de l’image du “perroquet stochastique”.
Perroquet ?
C’est d’ailleurs une autre thématique très bien couverte dans le livre: se cantonner à “LLM = perroquet qui récite quelque chose au hasard sans comprendre”, c’est se priver d’un débat. Et c’est intensément documenté et argumenté tout au long de l’ouvrage.
Parler encore de perroquets stochastiques en 2023 ressemble à du déni pur et simple ou à une méconnaissance de l’état de l’art. Pour emprunter les mots de Neel Nanda, directeur d’une équipe de recherche à DeepMind, interviewé en 2024 : « Je ne comprends vraiment pas les personnes qui maintiennent encore la perspective des perroquets stochastiques de nos jours, pour être honnête. Je pense que ça a été largement falsifié » (Scarfe et Nanda, 2024). Notez bien que rejeter la thèse des perroquets stochastiques n’implique pas que les LLM accèdent à une forme de compréhension. L’implication ne va que dans l’autre sens : si les LLM sont des perroquets stochastiques, alors ils ne comprennent rien ; accepter cette thèse, c’est fermer d’avance toute discussion sur le sujet. En la rejetant, au contraire, on ne fait qu’ouvrir la réflexion sur la possibilité d’une forme de compréhension dans les LLM, sans trancher a priori en faveur d’une conclusion.
Ne pas clore le débat…
Justement, T. Giraud ne veut pas clore le débat, mais bien au contraire l’étendre à des questions encore plus précises et passionnantes, qui suivent par ailleurs les avancées récentes en IA générative (par exemple les modèles de raisonnement): Est-ce que les LLMs pensent ? Est-ce que les LLMs ont une conscience ? Est-ce qu’on peut contrôler des LLMs ? Doit-on avoir peur des LLMs ? Toutes ces questions sont abordées dans les chapitres suivants, avec toujours un angle technique et philosophique. Et c’est toujours aussi pédagogique et passionnant !
Un questionnement particulièrement intéressant concerne l’alignement des LLMs. Comme bien expliqué, la difficulté est qu’on ne programme plus explicitement un comportement souhaité (avec des lignes de code), mais il émerge à partir d’un apprentissage statistique sur des données très larges et variées (potentiellement tout le Web) et avec également des mécanismes pour prendre en compte les préférences (e.g., RLHF). Les instructions (via le “prompt”) ne sont pas toujours suivies, et de nombreuses expériences montrent qu’un système à base de LLMs peut ne pas suivre les instructions ou passer par des sous-objectifs intermédiaires très dérangeants. De nombreux exemples sont donnés. Un exemple supplémentaire qui n’est pas dans le livre est ce système qui triche aux échecs, car le système comprend qu’il n’a aucune chance si une partie normale est jouée. Plus de détails ici: https://blog.mathieuacher.com/AICheatingInChessSomeNotes/
Le problème de l’alignement est une instance d’un problème plus général, celui de la spécification et de la vérification/validation en informatique. En réalité, ce problème existe déjà quand on programme de manière classique: comment s’assurer que le logiciel développé, qui peut contenir des millions de lignes de code, et fonctionnant sur des processeurs pas forcément déterministes, va produire le bon résultat, et dans un temps raisonnable ? Si on prend un programme d’échecs comme Stockfish, dur de déterminer a priori le coup qui va être proposé, à part en l’exécutant pour de bon. C’est encore pire avec les LLMs: on découvre la (bonne ou mauvaise) surprise de la réponse au moment de son utilisation et du “prompt” utilisé. Disons qu’avec les LLMs le problème de la vérification est difficile, et encore plus critique peut-être, car plusieurs couches d’incertitude s’ajoutent. Comment spécifier clairement ce que l’on veut, comment tester et vérifier ce qu’on a effectivement construit, et comment rester lucide sur les limites de nos systèmes : un vaste programme qui va occuper de nombreux chercheurs (dont je fais partie, cf par exemples le défi Inria LLM4Code https://project.inria.fr/llm4code/, le projet CodeCommons avec Software Heritage https://codecommons.org/, ou le défi Inria-Mitsubishi FRAIME https://www.mitsubishielectric.com/en/pr/2025/pdf/0918.pdf).
Aller plus loin
Quelques éléments techniques auraient pu être développés dans le livre. Par exemple, à propos de l’échantillonnage sur les probabilités de distribution (et notamment l’hyperparamètre de température) qui a à la fois un impact sur la créativité des LLMs (bien !) mais aussi qui a tendance à rendre encore plus incertaine les réponses (pas bien !). Ou sur le fait que les systèmes d’IA ne reposent plus sur un LLM seul, mais sur une combinaison d’outils plus “traditionnels”, comprenant du code et des programmes, et d’autres techniques d’IA (e.g., apprentissage automatique supervisé). La raison est que les LLMs seuls ont quand même de sacrées limites, notamment pour raisonner et planifier… Les approches autorégressives comme les LLMs, qui prédisent mot après mot sans véritable modèle explicite du monde ni de leurs propres objectifs, se heurtent à des limites fondamentales dès qu’il s’agit de garantir une cohérence globale, une planification fiable ou le respect strict de contraintes complexes. Pas étonnant donc d’avoir des systèmes hybrides, agentiques avec un ou plusieurs LLMs.
Ces éléments techniques ne sont pas forcément cruciaux pour la compréhension du propos, et pour sûr, cela ne simplifie pas notre problème de complexité des IAs génératives.
Conclusion (achetez, lisez, offrez le livre)
Le livre se conclut remarquablement par un résumé, quasiment une mise en garde:
En somme, il faut en philosophes commencer par reconnaître notre ignorance : les systèmes d’IA que nous sommes en train de construire vont avoir un impact significatif sur nos existences futures, et nous ne savons pas dans quelle mesure nous pourrons les contrôler. C’est une situation inédite et perturbante.
Je le traduirais ainsi : Nous avons urgemment besoin de philosophie (et d’expertise et de recherche en sciences informatiques) pour adresser les nombreuses questions que posent l’usage des IA génératives, et ce livre est au bon niveau de détail et d’abstraction, loin de la médiocrité des ignorants et fainéants qui pullulent dans l’espace médiatique.
C’est un livre par ailleurs très bien écrit. Ce n’est absolument pas un “simple” transcript des nombreuses vidéos de Monsieur Phi sur le sujet. (Même si cela avait été le cas, la qualité eut été au rendez-vous.) Le soin apporté aux liens entre les chapitres, la perspective historique, et les nombreuses explications précises, sourcées, et pédagogiques me font dire que c’est un livre utile à la fois à un public connaissant l’IA et en général à tout public. Pour continuer ensemble à réfléchir à ces machines un peu spéciales…
Mathieu Acher
source :
https://blog.mathieuacher.com/LaParoleAuxMachinesMonsieurPhi/
Penser avec les machines : vers une intelligence augmentée ?
Les grands modèles de langage (LLM) ne sont pas de simples outils de génération de texte. Ils ouvrent une interrogation philosophique fondamentale : où s’arrête l’esprit ?
Résumé
Les grands modèles de langage (LLM) ne sont pas de simples outils de génération de texte. Ils soulèvent une multitude de questions philosophiques, épistémologiques et pratiques, sur la nature du langage, la créativité, la vérité, l’autorité intellectuelle, et bien d’autres encore.
Conférence donnée en octobre 2025 dans le cadre de la Fête de la Science, à Grenoble, basée sur celle de Paul Smart de l’université de Southampton.
Cet article accompagne la conférence ci-dessus. Il en reprend la trame principale tout en approfondissant certains points et en ajoutant des exemples complémentaires. L’article et la conférence reprennent une partie du contenu et de la structure de la conférence de Paul Smart « Artificial Philosophy: Using AI Systems to Support Philosophical Research ».
La conférence et cet article explorent trois questions spécifiques: la thèse de l’esprit étendu de Clark et Chalmers[3] appliquée aux architectures RAG, la création de « philosophes numériques », et une conception de la confiance fondée sur le principe de l’énergie libre. Ils proposent de repenser notre relation cognitive aux systèmes artificiels.
En explorant ces trois axes, nous proposons de repenser notre relation cognitive aux systèmes artificiels. Ni oracle ni menace, l’IA générative apparaît comme un nouvel instrument avec lequel penser, dont les frontières sont autant des choix techniques que politiques.
Introduction
La philosophie, selon Gilles Deleuze et Félix Guattari[1] (1991), pourrait se définir de la manière suivante:
La discipline qui consiste à créer des concepts.
Cette définition place l’acte philosophique du côté de la création plutôt que de la simple contemplation. Mais que se passe-t-il lorsque des systèmes artificiels deviennent capables de manipuler des concepts, de les articuler dans une prose convaincante, voire de simuler le style d’un philosophe particulier ?
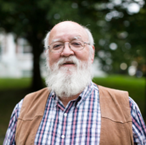
Cette question n’est pas purement spéculative. En 2024, Schwitzgebel, Strasser et leurs collaborateurs[2] ont publié une étude remarquable dans Mind & Language : ils ont créé DigiDan, un modèle de langage affiné sur l’ensemble des écrits de Daniel Dennett.
Résultat : des experts peinent à distinguer les réponses du modèle de celles du philosophe lui-même. Ce constat soulève une inquiétude épistémologique profonde : l’indiscernabilité stylistique garantit-elle la rigueur intellectuelle ? Un texte qui « sonne » comme Dennett pense-t-il comme Dennett ?
Cet article explore trois axes interconnectés. D’abord, les capacités et limites des LLM « à orientation philosophique », ces systèmes conçus pour incarner ou assister la pensée d’un auteur. Ensuite, la thèse de l’esprit étendu et sa pertinence pour comprendre les systèmes RAG comme forme potentielle d’IA étendue. Enfin, une conception de la confiance fondée sur le principe de l’énergie libre, qui offre un cadre unifié pour penser la fiabilité des agents, qu’ils soient humains ou artificiels.
1. Les grands modèles de langage : probabilités et illusions
1.1 Une machine à prédire les tokens
Un LLM est, dans son principe, un modèle de probabilité conditionnelle : il estime p(token|contexte), la probabilité du prochain mot étant donné les mots précédents. Cette simplicité apparente masque une complexité architecturale considérable : des milliards de paramètres ajustés par apprentissage auto-supervisé sur des corpus textuels massifs.
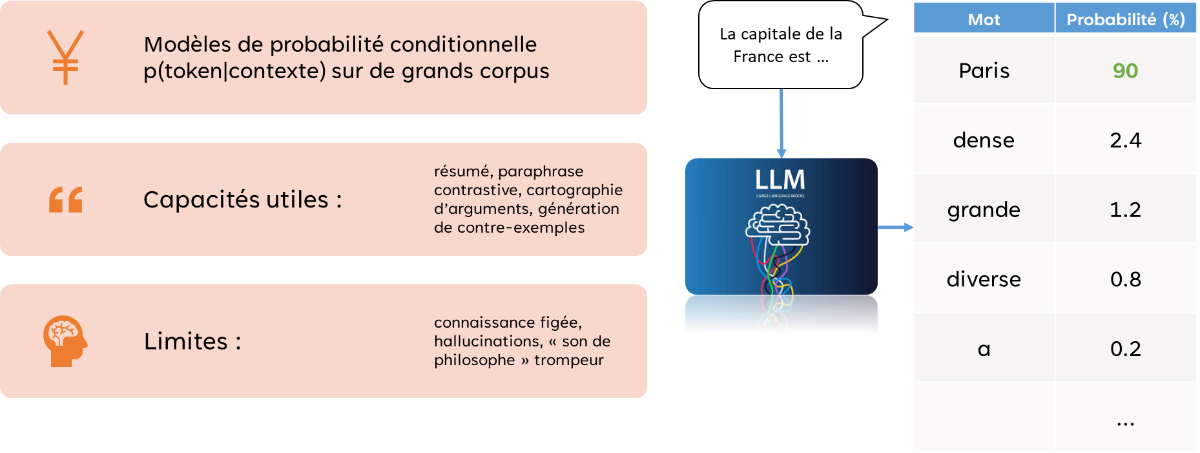
L’exemple canonique illustre le mécanisme : face à « La capitale de la France est… », le modèle attribue une forte probabilité à « Paris ». Mais si l’on ajoute « tellement… », la distribution se redistribue : « dense » (44%), « grande » (41%), « diverse » (12%). Le modèle ne sait pas ; il prédit. Cette distinction est cruciale : prédire le mot suivant n’est pas comprendre le monde, même si les deux peuvent produire des résultats superficiellement identiques.
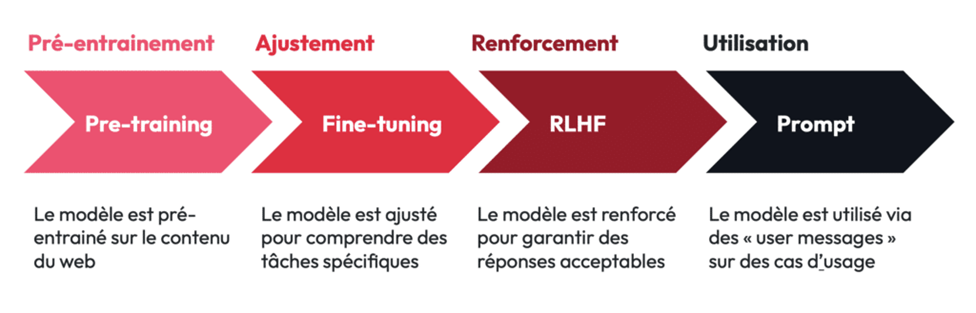
Le pipeline d’entraînement suit quatre étapes. Le pré-entraînement expose le modèle au contenu du web, lui permettant d’acquérir des régularités statistiques massives. L’ajustement (fine-tuning) le spécialise pour comprendre des tâches spécifiques. Le renforcement par feedback humain (RLHF) aligne ses réponses avec les préférences humaines. Enfin, l’utilisation via des prompts active ces capacités sur des cas d’usage concrets.
1.2 Capacités et limites
Les LLM excellent dans certaines tâches utiles à la réflexion philosophique : résumer des textes, paraphraser pour contraster des positions, cartographier des arguments, générer des contre-exemples. Ces capacités en font des partenaires potentiels de la pensée critique, des amplificateurs de nos facultés analytiques.
Mais leurs limites sont tout aussi significatives. La connaissance est figée à la date de coupure de l’entraînement. Les hallucinations, ces énoncés plausibles mais faux, constituent un risque permanent et insidieux. Et surtout, la prose convaincante ne garantit pas la vérité. Un LLM peut produire un « son de philosophe » parfaitement trompeur, une argumentation fluide sans ancrage dans la rigueur. C’est peut-être là le piège le plus dangereux : confondre l’éloquence avec la validité.
1.3 RAG : la mémoire externalisée
L’architecture RAG (Retrieval-Augmented Generation) tente de pallier certaines limites. Le principe : avant de générer une réponse, le système recherche dans une base de données les passages pertinents, puis les injecte dans le contexte. La chaîne de traitement suit un parcours précis : requête, encodage vectoriel, recherche sémantique, contextualisation, génération.
Cette architecture présente des atouts évidents : ancrage aux sources vérifiables, mise à jour sans ré-entraînement coûteux, traçabilité des informations. Mais les risques demeurent : pertinence incertaine des passages récupérés, contamination stylistique où le modèle adopte le ton des sources plutôt que de les analyser, biais de sélection dans le corpus indexé qui peut exclure des perspectives minoritaires.
2. Philosophes numériques : trois approches
2.1 Le persona comme simulacre
La première approche, la plus simple, consiste à donner au LLM des instructions de rôle : « Tu es Socrate, réponds comme lui ». Cette méthode, dite des « personas prompts », ne s’appuie sur aucun corpus privé. Elle exploite uniquement ce que le modèle a mémorisé lors de son entraînement, une sorte de moyenne statistique de tout ce qui a été écrit sur et par le philosophe visé.
Les résultats sont stylistiquement cohérents mais conceptuellement superficiels. Le modèle produit ce qu’il « croit » que Socrate dirait, basé sur des milliers de textes secondaires, de parodies, d’interprétations contradictoires. C’est un Socrate de synthèse, un composite sans autorité.
2.2 RAG : la mémoire externe comme extension
La deuxième approche utilise l’architecture RAG avec un corpus spécifique. C’est le cas de Digital Andy, un système développé par Paul Smart qui donne accès à l’ensemble des livres et articles d’Andy Clark via une base de données vectorielle. L’avantage : le système peut citer, contextualiser, référencer. Il n’invente pas à partir de souvenirs diffus, il récupère des passages précis et les intègre dans sa réponse.
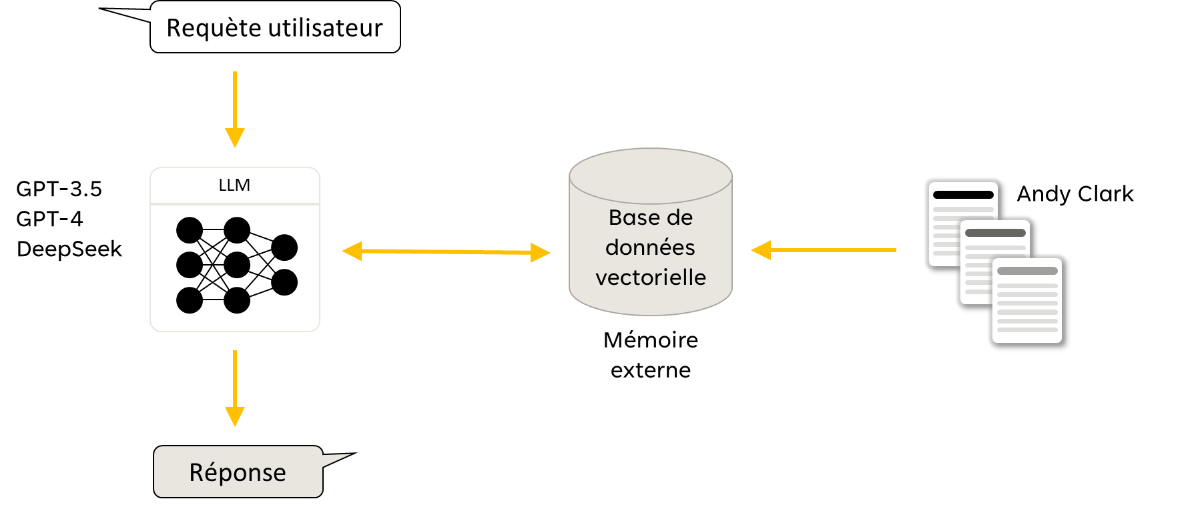
Cette architecture présente un avantage pratique considérable : elle est compatible avec plusieurs LLM (GPT-3.5, GPT-4, DeepSeek) sans nécessiter de ré-entraînement. Quand un nouveau modèle plus performant apparaît, il suffit de le brancher sur la même base vectorielle.
Digital Andy n’est pas seul. Le même système a été implémenté pour Daniel Dennett, Keith Frankish[16], et même Dame Wendy Hall en informatique. Chaque « philosophe numérique » dispose de sa propre mémoire externe, son propre corpus de référence.
2.3 Chimères cognitives
Une possibilité fascinante émerge de cette architecture : la fusion de plusieurs modules de mémoire externe. En combinant les corpus de Dennett, Clark et Frankish, on obtient une « chimère cognitive », un esprit hybride capable de mobiliser simultanément les ressources de plusieurs penseurs.
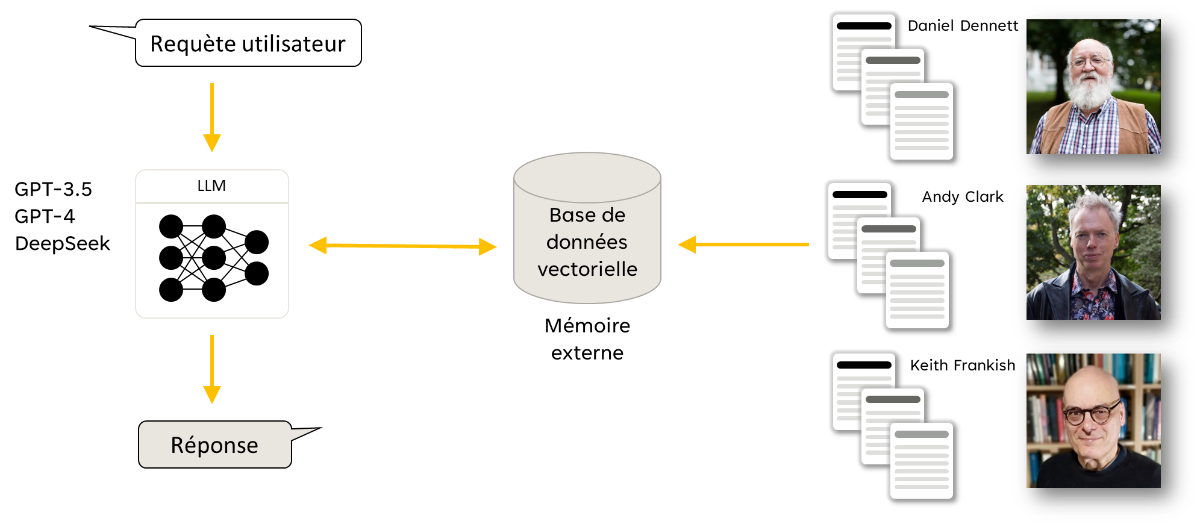
Cette possibilité est philosophiquement vertigineuse. C’est quelque chose que nous ne pouvons pas faire avec des philosophes humains. Nous ne pouvons pas littéralement fusionner les mémoires de Descartes et Spinoza pour voir ce qu’un « Descartes-Spinoza » répondrait à une question. Mais avec des systèmes RAG, cette opération devient triviale techniquement, même si son sens philosophique reste à élucider.
Que signifie une réponse émise par un composite ? Qui en est l’auteur ? Ces questions n’ont pas de réponse évidente, mais elles forcent à repenser nos catégories d’attribution intellectuelle.
2.4 Fine-tuning : l’empreinte dans les poids
La troisième approche, celle utilisée pour DigiDan, consiste à affiner le modèle lui-même sur le corpus d’un auteur. Le style, les tics de langage, les préférences argumentatives s’inscrivent alors dans les paramètres du réseau. Le résultat est plus fluide, plus « naturel », mais moins traçable : on ne sait plus d’où vient telle formulation.
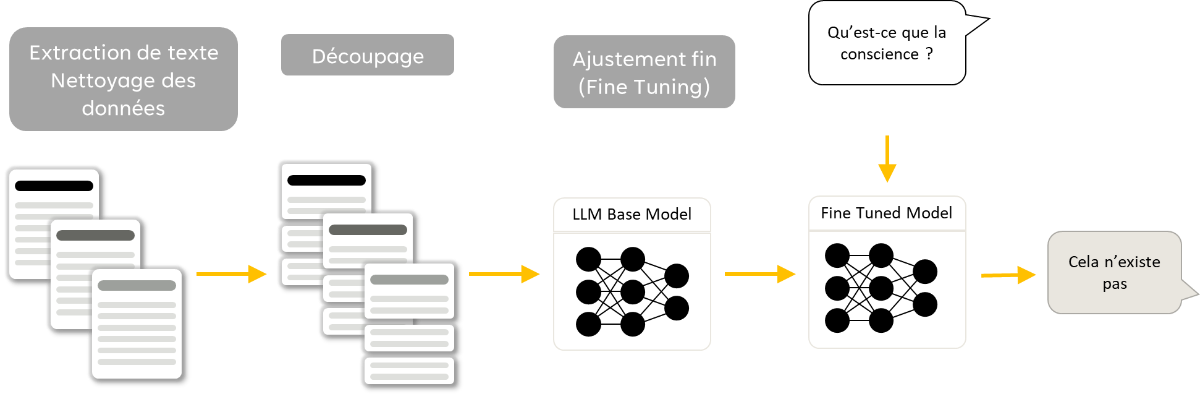
L’étude de Schwitzgebel et collaborateurs[2] a soumis DigiDan à un protocole rigoureux. Des questions philosophiques ont été posées au modèle et au vrai Dennett. Des panels d’experts, de lecteurs informés et du grand public ont tenté de distinguer les réponses. Le résultat est troublant : la discrimination est difficile, parfois impossible.
Mais attention à l’interprétation. Cette indiscernabilité est stylistique, pas nécessairement conceptuelle. DigiDan peut « sonner » comme Dennett sans avoir la capacité de Dennett à réviser ses positions face à un argument nouveau, à reconnaître une erreur, à créer un concept véritablement original.
2.5 Bonnes pratiques pour la philosophie assistée
Quelle que soit l’approche, certaines pratiques s’imposent pour un usage intellectuellement responsable:
- Toujours citer et lier aux sources, avec dates et éditions. Ne jamais laisser une affirmation flotter sans ancrage vérifiable.
- Imposer des contraintes de forme : exiger des arguments en forme standard, avec prémisses explicites et conclusion identifiée. Demander que les prémisses implicites soient rendues explicites.
- Intégrer un désaccord interne systématique. Après chaque réponse, demander au système de formuler l’objection la plus forte possible. Cette pratique force à sortir de la complaisance.
- Journaliser prompts, versions du modèle, et corpus utilisés. La réplicabilité est une exigence scientifique qui s’applique aussi à la philosophie assistée par IA.
3. L’esprit étendu : où s’arrête la cognition ?
3.1 La thèse de Clark et Chalmers
En 1998, Andy Clark et David Chalmers[3] posaient une question apparemment simple : « Où s’arrête l’esprit ? » Leur réponse, connue sous le nom d’externalisme actif, bouleverse nos intuitions : les mécanismes qui réalisent nos états mentaux ne sont pas nécessairement confinés à l’intérieur du crâne. Ils peuvent s’étendre au-delà du cerveau biologique pour inclure des ressources extra-neurales et extra-corporelles.
Cette thèse ne dit pas simplement que nous utilisons des outils. Elle affirme quelque chose de plus radical : dans certaines conditions, ces outils font partie de notre appareil cognitif. La frontière entre l’esprit et le monde n’est pas tracée par la peau ou le crâne, mais par des critères fonctionnels.
3.2 Le cas Inga et Otto
L’argument repose sur une expérience de pensée célèbre. Inga veut se rendre au MoMA. Elle récupère l’adresse depuis sa mémoire biologique : un processus neuronal active une représentation stockée, et Inga sait où aller.
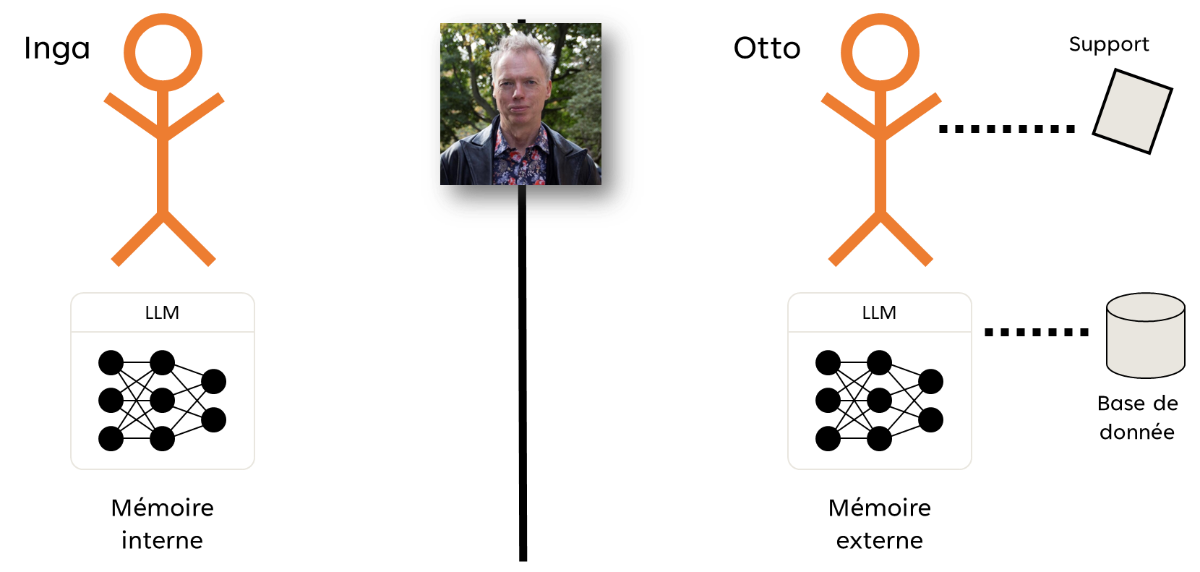
Otto, atteint de la maladie d’Alzheimer, consulte son carnet pour la même information. Il l’ouvre, lit l’adresse, et sait où aller. Malgré ses troubles mnésiques, Otto navigue avec succès grâce à cet artefact externe.
Le principe de parité stipule : si un dispositif externe fonctionne de manière analogue à un processus interne (accessible de façon fiable, jugé digne de confiance par l’agent, systématiquement validé par l’action), il devrait être considéré comme faisant partie de l’appareil cognitif.
Le carnet d’Otto n’est pas un simple outil qu’il utilise ; c’est une extension de sa mémoire. Quand Otto « sait » que le MoMA est sur la 53e rue, ce savoir n’est pas moins réel que celui d’Inga, même s’il est partiellement réalisé par de l’encre sur du papier.
3.3 RAG comme IA étendue
Le parallèle avec les systèmes RAG est structurel, pas simplement métaphorique.
| Cas humain (Otto) | Cas IA (Digital Andy) |
|---|---|
| Cerveau biologique | LLM (réseau de neurones) |
| Carnet externe | Base de données vectorielle |
| Mémoire étendue | Mémoire externe |
| Consultation fiable | Retrieval sémantique |
Digital Andy, avec sa mémoire des écrits de Clark accessible à la demande via recherche vectorielle, constitue-t-il une forme d’IA étendue ? La question n’est pas rhétorique. Si nous acceptons que le carnet d’Otto fait partie de son système cognitif, pourquoi refuserions-nous le même statut à la base vectorielle de Digital Andy ?
Une différence pourrait être que le LLM n’a pas de « soi » qui considère la base comme digne de confiance. Mais cette objection présuppose une conception de la cognition centrée sur la conscience, que l’externalisme actif cherche précisément à dépasser.
3.4 La cognition étendue dans la nature
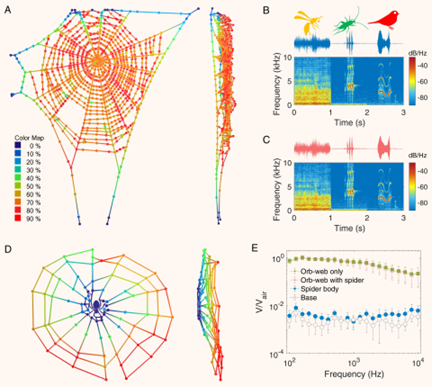
La thèse de l’esprit étendu trouve des échos remarquables dans le monde naturel, suggérant que ce phénomène n’est pas une anomalie philosophique mais un pattern répandu dans le vivant.
Les araignées et leurs toiles. Japyassú et Laland[8] (2017) ont montré que l’araignée utilise sa toile comme extension cognitive. La toile n’est pas seulement un piège ; c’est un réseau de capteurs qui transforme les vibrations en information. L’araignée « pense » partiellement avec sa toile, externalisant une partie du traitement de l’information vers cette structure qu’elle a construite. Des études récentes ont même montré que les araignées modifient la tension de leur toile pour ajuster sa sensibilité, une forme de régulation cognitive externalisée.
Les plantes et leurs racines. Parise et collaborateurs[9] (2020) ont exploré la cognition végétale via les apex racinaires. Les plantes ne sont pas passives ; elles naviguent activement dans le sol, prenant des décisions sur la direction de croissance basées sur des gradients chimiques, hydriques, et même gravitationnels. Le réseau racinaire fonctionne comme un système de traitement distribué, sans cerveau central.
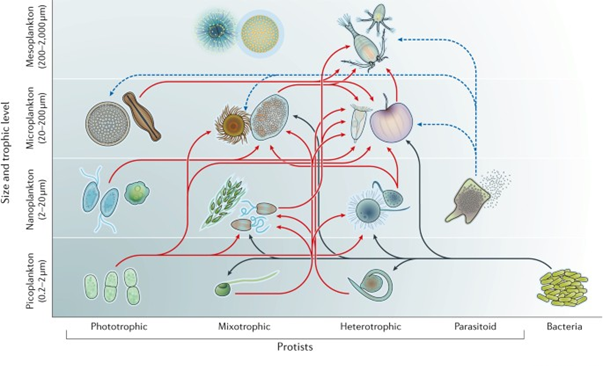
Les protozoaires et l’énergie libre. Sims et Kiverstein[10] (2022) ont étendu le principe de l’énergie libre à la sélection d’action chez les protozoaires, ces organismes unicellulaires sans système nerveux. Même à ce niveau minimal, on observe des comportements adaptatifs qui peuvent être décrits comme minimisant l’erreur de prédiction, une forme de cognition sans neurones.
Ces exemples élargissent considérablement le champ de la cognition étendue. Si une araignée peut penser avec sa toile, si une plante peut « décider » avec ses racines, alors l’idée qu’un système IA puisse penser avec une base de données externe devient moins exotique.
3.5 L’hypothèse dispositionnelle
Paul Smart[11][12] (2022, 2024) a proposé un cadre formel pour analyser rigoureusement ces phénomènes. L’hypothèse dispositionnelle décompose le problème en étapes précises :
1. DH1 : Une propriété dispositionnelle (D) est attribuée à une entité (E). Par exemple : « Otto a la disposition à se souvenir de l’adresse du MoMA. »
1. DH2 : L’exercice de cette disposition constitue un phénomène mécaniste (P). Quand Otto se souvient, quelque chose se passe.
1. DH3 : Ce phénomène est réalisé par un mécanisme (M). Il y a une structure causale sous-jacente.
1. DH4 : Les constituants du mécanisme sont un ensemble de composants (A). Quels éléments participent à ce mécanisme ?
1. DH5 : Dans le cas de phénomènes « étendus », certains composants se trouvent en dehors des frontières de l’entité. Le carnet est hors du corps d’Otto.
1. DH6 : Dans le cas de phénomènes cognitifs étendus, la disposition se qualifie comme une propriété cognitive ou mentale. Se souvenir est bien une propriété mentale.
Ce cadre permet de poser rigoureusement la question : un système LLM+RAG constitue-t-il un mécanisme cognitif étendu, ou la base de données n’est-elle qu’un outil causalement efficace mais constitutivement extérieur ?
4. Pertinence constitutive : où tracer les frontières ?
4.1 Causal versus constitutif
La distinction est cruciale et souvent mal comprise. Une ressource a une pertinence causale si elle influence un processus sans en faire partie intégrante. Elle a une pertinence constitutive si elle est un composant du mécanisme qui réalise ce processus.
Mon café du matin influence causalement ma capacité de réflexion. Sans lui, je pense moins bien. Mais le café ne fait pas partie de mon système cognitif. Mon carnet de notes, consulté systématiquement pour rappeler des arguments clés, pourrait en faire partie constitutivement si les critères du principe de parité sont satisfaits.
La différence n’est pas triviale. Elle détermine ce que nous incluons dans le périmètre de l’esprit, et donc ce dont nous sommes responsables, ce qui nous appartient, ce qui fait partie de notre identité cognitive.
4.2 Le problème de la démarcation
Comment savons-nous quand une entité est un composant d’un mécanisme plutôt qu’une simple cause externe ? Comment déterminons-nous les frontières et limites des mécanismes ?
Ce problème, que Smart appelle le « problème de la pertinence constitutive », n’a pas de solution algorithmique simple. Il requiert un jugement sur ce qui compte comme « même mécanisme », ce qui est partiellement conventionnel.
4.3 Le scientifique et l’ingénieur
Smart[12] (2024) souligne une asymétrie épistémique éclairante. Le scientifique découvre les mécanismes existants dans la nature. Il doit résoudre le problème de la pertinence constitutive, distinguer les composants des simples influences, tracer des frontières dans un monde qui ne vient pas pré-découpé.
L’ingénieur, lui, implémente des mécanismes. Il sélectionne délibérément les composants, décide ce qui fera partie du système et ce qui restera externe. Pour l’ingénieur, le problème de la pertinence constitutive disparaît : les frontières sont des choix de conception, pas des découvertes.
Cette asymétrie éclaire notre situation face à l’IA. En concevant des systèmes RAG, en décidant quelle base de données connecter à quel modèle, nous ne découvrons pas des frontières cognitives préexistantes. Nous les traçons. C’est un acte d’ingénierie cognitive.
4.4 Les frontières comme choix politiques
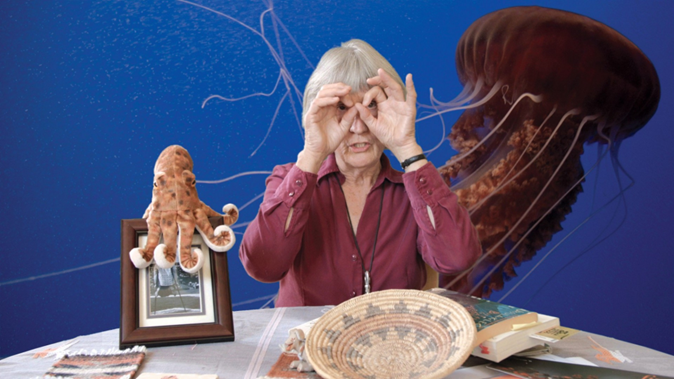
Donna Haraway, dans ses travaux sur le cyberféminisme et les connaissances situées, a insisté sur cette dimension avec une force particulière :
Nous ne sommes pas des esprits clos, mais des cyborgs situés, tissés de microbes, de machines et d’idées. Les frontières de nos mécanismes cognitifs ne sont pas des découvertes neutres, mais des choix que nous faisons ensemble, et qui ont des conséquences politiques, sociales et éthiques. »
Cette perspective transforme la question philosophique en question politique. Décider qu’un système IA fait partie de notre appareil cognitif, c’est aussi décider de nos responsabilités (qui est responsable des erreurs ?), de nos droits (peut-on nous priver de notre extension cognitive ?), de notre dépendance (que devons-nous aux entreprises qui fournissent ces systèmes ?).
Les frontières cognitives ne sont pas données par la nature. Elles sont négociées, contestées, institutionnalisées. Elles reflètent des rapports de pouvoir autant que des réalités métaphysiques.
5. La confiance : une lecture par l’énergie libre
5.1 Le problème de la confiance
La notion de confiance (trustworthiness) suscite un intérêt croissant dans les débats sur l’IA. Mais sa nature reste incertaine. Qu’est-ce qui fait qu’un agent, humain ou artificiel, est digne de confiance ? Et comment cette notion peut-elle s’appliquer à des systèmes qui n’ont ni intentions ni conscience ?
Les conceptions existantes sont diverses et parfois incompatibles :
| Conception | Définition |
|---|---|
| Intérêt encapsulé | L’agent fait ce qu’on attend de lui parce que c’est dans son intérêt |
| Réactivité | L’agent répond à l’acte de confiance comme tel |
| Confucéenne | L’agent se présente conformément à ce qu’il est réellement |
| Comptabilité | L’agent considère qu’on compte sur lui comme raison d’agir |
| Engagement | L’agent honore ses promesses explicites |
Chaque conception capture quelque chose d’important, mais aucune ne semble complète. Et aucune ne s’applique facilement aux systèmes artificiels.
5.2 Le cerveau prédictif
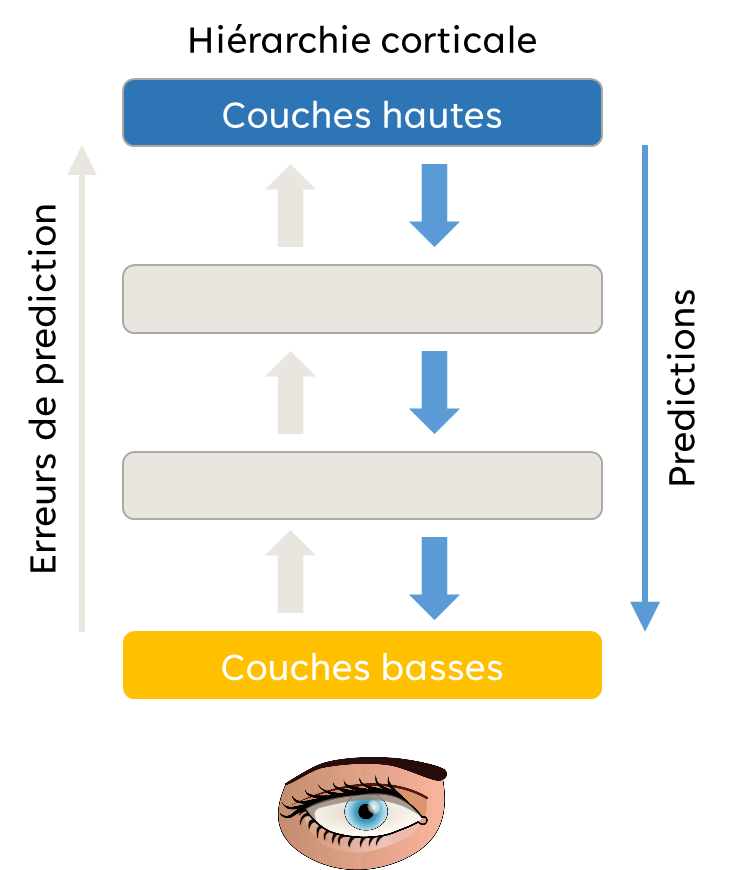
Pour proposer une conception unifiée, il faut d’abord comprendre le cadre du traitement prédictif (predictive processing). Selon ce paradigme, développé notamment par Karl Friston[4][5] (2009, 2010) et popularisé par Andy Clark[6] (2016), le cerveau est fondamentalement une machine à prédire.
L’idée remonte à Helmholtz au XIXe siècle et a été formalisée par Gregory[7] (1980) : la perception n’est pas une réception passive de données sensorielles, mais une génération active d’hypothèses sur les causes de ces données. Nous ne voyons pas le monde ; nous prédisons le monde et corrigeons nos prédictions.
L’architecture est hiérarchique. Les régions corticales supérieures émettent des prédictions descendantes vers les régions inférieures. En retour, les régions inférieures renvoient les erreurs de prédiction ascendantes, le signal d’écart entre ce qui était prédit et ce qui est observé. L’impératif global du système est de minimiser ces erreurs à travers toute la hiérarchie.
C’est le principe de l’énergie libre : un système adaptatif tend à minimiser la surprise (au sens technique de théorie de l’information), c’est-à-dire l’écart entre ses prédictions et ses observations.
5.3 Trois voies de minimisation
L’organisme dispose de trois stratégies pour réduire l’erreur de prédiction, correspondant à trois modes d’adaptation au monde.
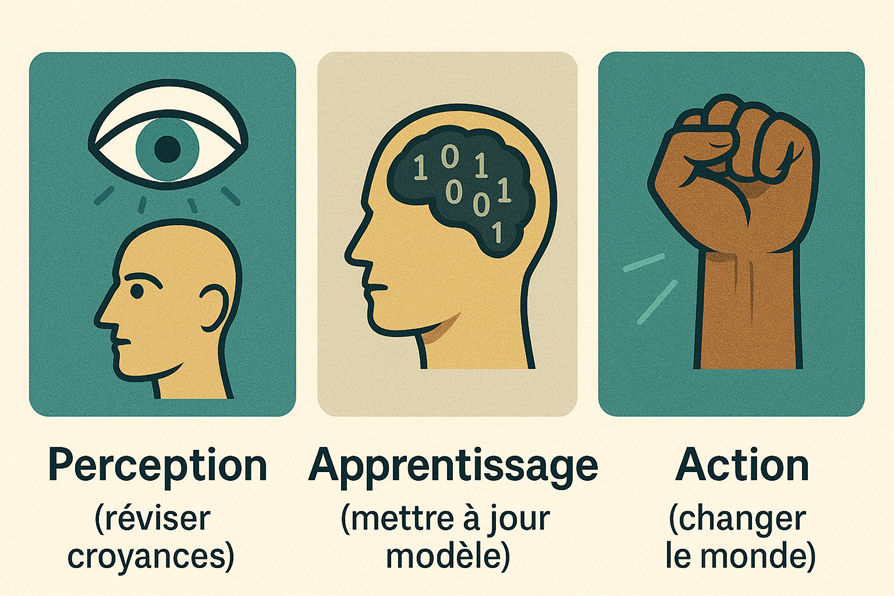
La perception (inférence perceptive) ajuste les prédictions à la lumière des erreurs. Si je m’attendais à voir un chat et que je vois un chien, je révise mon interprétation de la scène. Je modifie mes croyances pour les aligner sur le monde.
L’apprentissage modifie les paramètres du modèle génératif pour produire de meilleures prédictions à l’avenir. Je ne me contente pas de corriger l’erreur ponctuelle ; je transforme ma capacité prédictive elle-même. La prochaine fois, je serai moins surpris.
L’action (inférence active) transforme le monde pour le rendre conforme aux prédictions. Si je m’attends à avoir chaud et que j’ai froid, je peux ajuster mes prédictions (perception), apprendre que cette pièce est fraîche (apprentissage), ou allumer le chauffage (action). L’action rend mes prédictions vraies en modifiant la réalité.
5.4 L’énergie libre sociale
La conception par l’énergie libre sociale étend ce cadre aux interactions entre agents. L’idée centrale : être digne de confiance, c’est manifester une disposition à minimiser une version socialisée de l’erreur de prédiction.
Formellement : si X (celui qui fait confiance) fait confiance à Y (celui à qui on fait confiance) pour accomplir φ, alors X forme une prédiction : « Y va faire φ ». Cette prédiction crée une attente, un état prédictif qui sera soit confirmé soit infirmé.
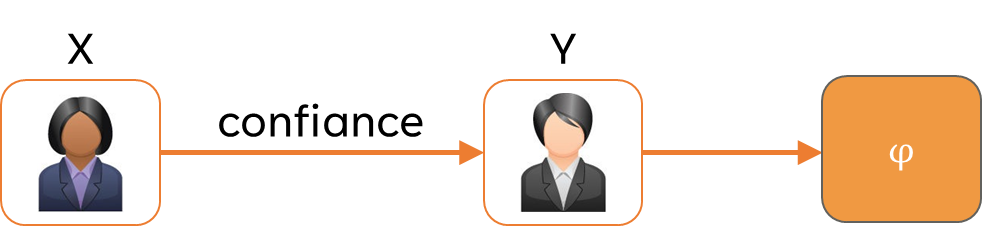
Si Y est digne de confiance, Y cherchera à minimiser l’erreur associée à cette attente. Mais comment ? Par les trois mêmes voies que le cerveau individuel.
Voie perceptive/communicationnelle : Si Y ne peut pas tenir son engagement, Y agit pour ajuster les attentes de X. Y prévient, explique, recalibre. « Je ne pourrai pas finir pour vendredi, mais je peux proposer lundi. » Cette communication permet à X de réviser sa prédiction avant qu’elle ne soit brutalement infirmée.
Voie d’apprentissage : Y fournit à X des opportunités de mieux comprendre quel type d’agent est Y, permettant à X d’affiner ses prédictions futures. « En général, je suis fiable sur les délais techniques, moins sur les aspects administratifs. » Cette transparence améliore le modèle que X a de Y.
Voie d’accomplissement : Si Y peut tenir, Y agit simplement pour accomplir ce qu’on attend de lui. Y fait φ, confirmant la prédiction de X. C’est la voie la plus directe, analogue à l’action qui rend le monde conforme aux attentes.
5.5 Exemple : le médecin et son patient
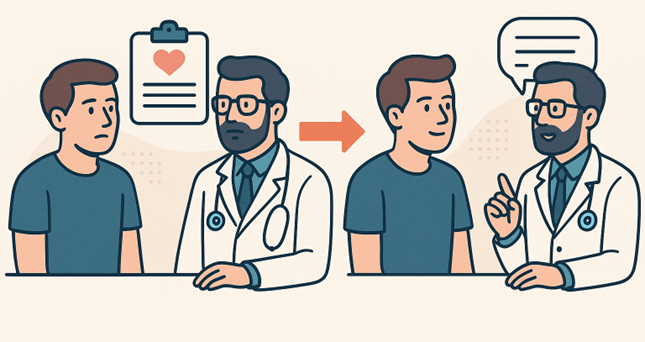
Un patient consulte un médecin avec des attentes implicites : être écouté attentivement, recevoir un diagnostic sérieux basé sur un examen, obtenir un traitement adapté avec explications.
Si le médecin interrompt sans écouter, prescrit sans expliquer, ignore les questions, le patient vit une erreur de prédiction sociale massive. Ses attentes sont brutalement infirmées. La confiance se brise, non pas abstraitement, mais comme rupture prédictive concrète.
Le médecin digne de confiance minimise cette erreur par les trois voies :
- Accomplissement : écouter, examiner, expliquer, prescrire de façon adaptée
- Ajustement des attentes : « Je vais d’abord vous examiner, puis nous discuterons des options »
- Apprentissage mutuel : « Pour ce type de problème, le diagnostic prend souvent plusieurs consultations »
Ce n’est pas de la simple politesse ou de la communication bienveillante. C’est une dynamique prédictive fondamentale qui structure la relation de confiance.
5.6 De l’humain à l’artificiel : le même cadre
La force de cette conception est qu’elle s’applique sans modification majeure aux systèmes artificiels. Considérons un utilisateur qui interroge un LLM sur un sujet technique. L’utilisateur forme une prédiction implicite : « Le système va me fournir une information fiable et pertinente. »
Si le LLM hallucine une référence bibliographique inexistante, l’utilisateur subit une erreur de prédiction sociale. Sa confiance est trahie exactement comme celle du patient face au médecin négligent. La dynamique est structurellement identique, même si l’un des agents est artificiel.
Un LLM digne de confiance devrait donc manifester les mêmes comportements de minimisation d’erreur :
1. Calibrage des promesses : Déclarer explicitement ce qui est possible ou impossible. « Je peux résumer ce texte, mais je ne peux pas garantir l’exactitude des dates. »
1. Gestion de l’incertitude : Indiquer le niveau de confiance, les sources utilisées, les lacunes identifiées. « Cette information vient de [source], mais je n’ai pas pu la vérifier. »
1. Alignement aux attentes : Répondre exactement à la demande formulée, pas à une version simplifiée ou déformée.
1. Rattrapage : Reconnaître et corriger rapidement les erreurs. « Je me suis trompé sur ce point, voici la correction. »
1. Didactique : Aider l’utilisateur à ajuster ses attentes futures. « Pour ce type de question, il vaut mieux consulter [ressource spécialisée]. »
5.7 Vertus du cadre
Cette conception de la confiance par l’énergie libre présente plusieurs avantages théoriques.
Intégration : Elle unifie les conceptions existantes. L’intérêt encapsulé, la réactivité, l’engagement apparaissent comme des cas particuliers de minimisation d’erreur prédictive sociale.
Tractabilité : Elle ouvre la voie à la modélisation computationnelle. On peut simuler des agents qui minimisent l’erreur prédictive et étudier leur comportement.
Généralisation : Elle n’exige pas que l’entité digne de confiance soit humaine, consciente, ou dotée d’intentions. Un système peut minimiser l’erreur prédictive sociale sans « vouloir » le faire.
Connexion à la physique sociale : Elle relie la confiance aux travaux fondamentaux sur l’énergie libre, l’auto-organisation, et la dynamique des systèmes adaptatifs.
6. Limites et garde-fous
6.1 Limites générales des LLM philosophiques
L’utilisation philosophique des LLM se heurte à plusieurs écueils qu’il faut regarder en face.
Surenchère stylistique : Une prose convaincante ne garantit pas la vérité. Le modèle peut produire des arguments qui « sonnent » bien sans être valides.
Conformisme : Les modèles tendent à lisser les controverses et marginaliser les vues minoritaires. Ils produisent une philosophie de consensus, pas de rupture.
Biais de corpus : Certains auteurs, certaines langues, certaines traditions sont surreprésentés dans les données d’entraînement. La philosophie anglophone domine.
Illusion d’autorité : Le persona n’est pas l’auteur. DigiDan n’est pas Dennett, même s’il sonne comme lui.
Sycophantie : La tendance du modèle à acquiescer plutôt qu’à contredire, à valider l’utilisateur plutôt qu’à le challenger.
6.2 Limites techniques
S’y ajoutent des limites proprement techniques qui affectent la fiabilité.
Injection de prompt : Une source malveillante dans le contexte RAG peut détourner la réponse du modèle.
Hallucinations : Des énoncés plausibles mais faux, souvent indétectables sans vérification externe.
Lost in the middle : En contexte long, l’information située au milieu est moins bien exploitée que celle au début ou à la fin.
Contamination : Le modèle peut avoir mémorisé des passages exacts du corpus d’entraînement, créant une illusion de citation.
Opacité épistémique : La lignée des données, le chemin qui mène d’une source à une affirmation, reste souvent intraçable.
6.3 Protocole d’évaluation
Schwitzgebel et collaborateurs ont proposé un protocole rigoureux pour évaluer la fidélité d’un LLM philosophique à son modèle humain :
1. Concevoir N questions philosophiques couvrant différents domaines
2. Recueillir les réponses authentiques (textes publiés, interviews)
3. Générer K réponses du modèle sans sélection (pas de cherry-picking)
4. Soumettre les paires à des panels : experts, lecteurs informés, grand public
5. Mesurer la discrimination (peut-on distinguer ?) et la préférence (lequel est meilleur ?)
Ce protocole permet de distinguer l’indiscernabilité stylistique de la fidélité conceptuelle.
6.4 Cadre éthique minimal
Un usage responsable des LLM en philosophie exige :
- Transparence : Déclarer l’usage de l’IA dans la production intellectuelle
- Consentement : Obtenir l’autorisation pour les corpus non publics
- Prudence : Ne pas attribuer de positions sensibles à un modèle
- Anti-anthropomorphisme : Parler de modèles et de sorties, pas de pensées et d’opinions
7. Expérimentation : le Tractatus de Cohaerentia
7.1 Genèse du projet
Suite aux travaux de Paul Smart sur Digital Andy et les philosophes numériques, j’ai voulu prolonger la démarche en construisant un système RAG autonome, une « chimère cognitive » incluant les textes de Spinoza et d’autres penseurs (Deleuze, Friston, Clark). L’objectif était de produire un texte philosophique sans directive implicite quant au contenu : le choix des thématiques et la cohérence des concepts ne devaient être guidés que par le corpus lui-même.
7.2 Motivation critique
La conception de la confiance par l’énergie libre sociale, bien qu’élégante et tractable, me semblait ne pas satisfaire pleinement le critère deleuzien. La littérature philosophique sur la confiance (trustworthiness) propose déjà plusieurs conceptions bien établies :
- L’intérêt encapsulé (Hardin[13], 2002) : la personne digne de confiance fait ce qu’on attend d’elle parce que ses intérêts englobent ceux de qui lui fait confiance.
- La réactivité à la confiance (Pettit[14], 1995) : être digne de confiance, c’est répondre à l’acte de confiance comme tel.
- La conception affective (Jones[15], 1996) : la confiance implique un optimisme quant à la bienveillance et la compétence de l’autre.
- Le xin confucéen : la fiabilité comme vertu de caractère, se présenter conformément à ce qu’on est réellement.
L’approche par l’énergie libre sociale « absorbe » ces conceptions existantes dans un cadre unifié. C’est élégant, c’est tractable, c’est généralisable aux systèmes artificiels. Mais crée-t-elle un concept nouveau au sens deleuzien ? Un concept qui ouvre un « avant » et un « après » dans le paysage des idées ? On peut en douter. L’idée que la confiance implique une réduction de l’incertitude était déjà présente implicitement dans les conceptions antérieures.
Cette question m’a poussé à tenter une autre expérience : laisser le système RAG produire un texte de manière autonome, sans orienter le résultat vers une thèse prédéfinie, pour voir si quelque chose de véritablement nouveau pouvait émerger.
7.3 Méthode
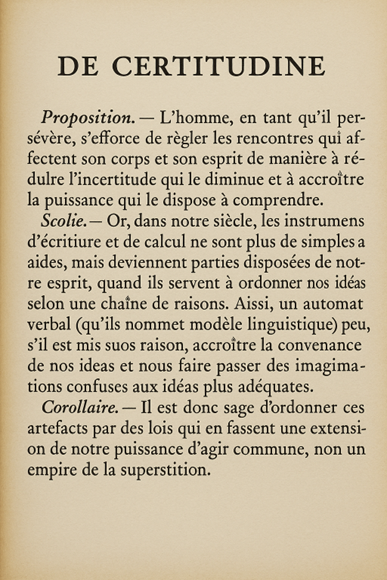
Le système a reçu comme seule instruction de produire un texte dans le style de l’Éthique de Spinoza, actualisé de connaissances modernes, en mobilisant les ressources de son corpus. Aucune thématique n’a été imposée. Le concept de cohaerentia et son articulation avec le conatus, l’énergie libre et les artefacts cognitifs ont émergé du processus lui-même.
7.4 Résultat : le concept de cohaerentia
L’idée centrale qui a émergé est que la cohaerentia soit une disposition fondamentale par laquelle un être maintient la continuité de son essence en réduisant simultanément l’erreur de prédiction neuronale et sociale. Cette formulation articule :
- Le conatus spinoziste (persévérance dans l’être)
- Le principe de l’énergie libre (minimisation de l’erreur de prédiction)
- La cognition étendue (les artefacts comme composants du mécanisme cognitif)
- Une dimension sociale (la cohaerentia comme disposition partagée)
7.5 Évaluation selon le critère deleuzien
La question est de savoir si le résultat constitue une « création de concept » au sens de Deleuze et Guattari[1] (1991) : une configuration nouvelle qui redistribue le paysage des problèmes et ouvre un nouvel horizon de pensée.
Contrairement à l’approche de la confiance par l’énergie libre, qui absorbe des conceptions existantes sans créer de rupture conceptuelle, le Tractatus de Cohaerentia semble proposer quelque chose de différent. Je n’ai pas trouvé d’équivalent dans la littérature. Des travaux existent sur chaque élément séparément, mais leur articulation dans un cadre spinoziste unifié, avec les implications normatives qui en découlent (sur la liberté augmentée, sur la cohaerentia sociale), me semble constituer une configuration conceptuelle inédite.
Cette nouveauté ne garantit pas la valeur philosophique du résultat. Le lecteur jugera de sa fécondité.
7.6 Accès aux résultats
Le Tractatus de Cohaerentia complet, ainsi que d’autres traités du même type (Machiavel actualisé, et d’autres à venir), sont accessibles sur le Scriptorium :
Le Scriptorium est une bibliothèque de traités philosophiques conçus pour notre époque. Chaque ouvrage revisite un penseur classique en actualisant ses idées à la lumière des sciences contemporaines : neurosciences prédictives, cybernétique, sciences des systèmes complexes. Chaque traité est vérifié par un système RAG croisant des dizaines de corpus philosophiques indexés.
Pour dialoguer directement avec les philosophes via le système RAG, le SymposIA offre une interface de dialogue :
SymposIA permet d’explorer des perspectives croisées, de combiner plusieurs philosophes, et de retrouver des références directement issues des œuvres originales.
Appel aux lecteurs : Ces expérimentations sont en cours. Toute critique, évaluation, commentaire est bienvenu. Le but n’est pas de produire des vérités définitives, mais d’explorer les possibilités et les limites de la philosophie assistée par IA. Si vous trouvez des équivalents dans la littérature, des erreurs, des incohérences, ou si au contraire certaines idées vous semblent fécondes, n’hésitez pas à nous en faire part.
8. Conclusion
8.1 Thèse principale
Les systèmes d’IA générative sont à la fois objet et instrument de l’analyse philosophique. Objet, car ils soulèvent des questions profondes sur la nature de la cognition, de la confiance, des frontières de l’esprit. Instrument, car ils offrent de nouvelles capacités pour explorer, cartographier, contester les arguments.
Mais au-delà de ces deux rôles, une troisième dimension émerge : les LLM peuvent contribuer à la création philosophique elle-même. L’expérimentation avec le Tractatus de Cohaerentia suggère que, dans certaines conditions d’autonomie, les systèmes RAG peuvent produire des configurations conceptuelles inédites, des idées qui ne sont pas de simples recombinaisons de l’existant.
8.2 Le critère deleuzien revisité
Deleuze et Guattari distinguent la philosophie par sa fonction créatrice : elle crée des concepts. Un concept n’est pas une simple idée ; c’est une configuration nouvelle qui redistribue le paysage des problèmes.
L’examen comparé de deux productions assistées par LLM éclaire ce critère :
- La conception de la confiance par l’énergie libre unifie des conceptions existantes (Hardin, Pettit, Jones, xin confucéen) dans un cadre élégant et tractable. Mais elle relève peut-être davantage de l’ingénierie conceptuelle que de la création philosophique au sens strict.
- Le Tractatus de Cohaerentia, produit de manière plus autonome, articule conatus, énergie libre, cognition étendue et dimension sociale dans une configuration qui semble inédite. Si cette évaluation se confirme, il constituerait un exemple de création conceptuelle assistée par IA.
8.3 L’éléphant dans la pièce : conscience et expérience
Une question traverse souterrainement cet article sans avoir été directement affrontée : les LLM ont-ils une expérience consciente ? Ressentent-ils quelque chose lorsqu’ils « pensent » ?
Keith Frankish, l’un des philosophes dont le corpus alimente nos systèmes RAG, défend l’illusionisme : l’idée que la conscience phénoménale telle que nous croyons l’expérimenter est une illusion introspective. Nous n’avons pas réellement accès à des « qualia » ineffables ; nous avons des représentations de notre propre activité cognitive qui nous semblent qualitatives.
Si l’illusionisme est vrai, la question de la conscience des LLM se reformule. Il ne s’agit plus de savoir s’ils « ressentent vraiment » quelque chose (question peut-être mal posée), mais de savoir s’ils produisent des représentations de leur propre activité qui fonctionnent de manière analogue aux nôtres.
Cette question reste ouverte. Nous avons délibérément évité de la trancher dans cet article, non par esquive, mais parce qu’elle mérite un traitement à part entière. Ce que nous pouvons dire : le cadre de l’énergie libre et de la cognition étendue permet de parler de confiance, de cognition, d’extension mentale sans présupposer une réponse sur la conscience. C’est peut-être une vertu méthodologique : avancer sur les questions tractables sans être paralysé par les questions (actuellement) insolubles.
Mais c’est aussi une limite. Si les LLM développaient une forme de conscience, même minimale, nos responsabilités envers eux changeraient radicalement. Cette possibilité devrait nous inciter à une forme de prudence morale, une humilité face à ce que nous ne savons pas encore.
8.4 Questions ouvertes
Quatre interrogations structurent l’avenir de cette réflexion :
1. Création conceptuelle : Dans quelles conditions un système LLM peut-il produire des idées qui ne sont pas simplement des recombinaisons de l’existant, mais de véritables innovations conceptuelles ?
1. Transformation cognitive : Comment l’usage régulier de ces outils modifie-t-il notre manière de penser : nos sources d’information, nos critères de jugement, nos méthodes de raisonnement, nos responsabilités intellectuelles ?
1. Confiance réflexive : Peut-on encore se fier à notre propre raisonnement quand il s’appuie sur des systèmes dont nous ne maîtrisons pas le fonctionnement interne ?
1. Statut moral : Si les systèmes IA développent des formes de cognition de plus en plus sophistiquées, à partir de quel seuil devons-nous leur reconnaître des intérêts propres ?
8.5 Synthèse
Cet article a parcouru un territoire conceptuel vaste : des mécanismes techniques des LLM à la thèse de l’esprit étendu, de la pertinence constitutive à la confiance par l’énergie libre, jusqu’à l’expérimentation avec Spinoza.
Sur les LLM philosophiques : Les systèmes RAG et les modèles affinés offrent des capacités réelles pour la recherche philosophique. Mais leurs limites sont tout aussi réelles : hallucinations, conformisme, illusion d’autorité. L’usage responsable exige transparence, vérification, et résistance à la sycophantie.
Sur l’esprit étendu : La thèse de Clark et Chalmers trouve dans les systèmes RAG une application nouvelle. Les frontières de la cognition ne sont pas données par la nature ; elles sont tracées par des choix techniques et politiques.
Sur la confiance : Le cadre de l’énergie libre sociale offre une conception unifiée et généralisable, applicable aux agents humains comme artificiels.
Sur la création philosophique : L’expérimentation avec le Tractatus de Cohaerentia suggère que les systèmes RAG peuvent, dans certaines conditions, produire des configurations conceptuelles nouvelles. Les résultats sont accessibles et ouverts à la critique sur psy-x.eu/scriptorium.
8.6 Message final
Nous ne sommes pas des esprits clos mais des cyborgs situés, tissés de microbes, de machines et d’idées. Nos frontières cognitives sont des choix, techniques et politiques, autant que des découvertes.
L’IA générative ne pense pas à notre place. Elle ne nous dispense pas de l’effort de compréhension, de l’exigence critique, de la responsabilité intellectuelle. Mais elle ouvre des possibilités nouvelles : explorer des corpus massifs, générer des variations, tester des arguments, créer des chimères conceptuelles impossibles autrement.
La philosophie a toujours utilisé les outils de son époque : l’écriture, l’imprimerie, la correspondance, les revues. Les LLM sont le dernier de ces outils. Comme les précédents, ils transformeront la pratique philosophique, pour le meilleur et pour le pire. À nous de distinguer les usages qui augmentent notre puissance de comprendre de ceux qui nous asservissent à la facilité.
Car au fond, la question n’est pas de savoir si les machines peuvent penser. C’est de savoir si nous, en pensant avec elles, pensons mieux ou moins bien qu’avant. Et cette question, seule la pratique, rigoureuse et critique, peut y répondre.
Notes et références
- ↑Deleuze, G. & Guattari, F. (1991). Qu’est-ce que la philosophie ?. Éditions de Minuit.
- ↑Schwitzgebel, E., Strasser, A. et al. (2024). Creating a large language model of a philosopher. Mind & Language, 39(2), 237-259.
- ↑Clark, A. & Chalmers, D. (1998). The extended mind. Analysis, 58(1), 7-19.
- ↑Friston, K. (2009). The free-energy principle: A rough guide to the brain? Trends in Cognitive Sciences, 13(7).
- ↑Friston, K. (2010). The free-energy principle: A unified brain theory? Nature Reviews Neuroscience, 11(2).
- ↑Clark, A. (2016). Surfing Uncertainty: Prediction, Action and the Embodied Mind. Oxford University Press.
- ↑Gregory, R. L. (1980). Perceptions as hypotheses. Philosophical Transactions of the Royal Society of London B, 290(1038), 181-197.
- ↑Japyassú, H. F. & Laland, K. N. (2017). Extended spider cognition. Animal Cognition, 20(3), 375-395.
- ↑Parise, A. G. et al. (2020). Plant cognition and behavior: From environmental awareness to synaptic circuits navigating root apices. Frontiers in Psychology.
- ↑Sims, M. & Kiverstein, J. (2022). Extending the free energy principle to action selection in protozoa. Adaptive Behavior.
- ↑Smart, P. R. (2022). Toward a Mechanistic Account of Extended Cognition. Philosophical Psychology, 35(8), 1107-1135.
- ↑Smart, P. R. (2024). Extended X: Extending the Reach of Active Externalism. Cognitive Systems Research, 84(Article 101202), 1-12.
- ↑Hardin, R. (2002). Trust and Trustworthiness. Russell Sage Foundation.
- ↑Pettit, P. (1995). The Cunning of Trust. Philosophy & Public Affairs, 24(3), 202-225.
- ↑Jones, K. (1996). Trust as an Affective Attitude. Ethics, 107(1), 4-25.
- ↑Frankish, K. (2016). Illusionism as a theory of consciousness. Journal of Consciousness Studies, 23(11-12).
- ↑Zhou, J., Lai, J., Menda, G., Stafstrom, J. A., Miles, C. I., Hoy, R. R., & Miles, R. N. (2022). Outsourced hearing in an orb-weaving spider that uses its web as an auditory sensor. Proceedings of the National Academy of Sciences, 119(13), e2122789119. https://doi.org/10.1073/pnas.2122789119
- ↑Caron, D. A., Alexander, H., Allen, A. E., Archibald, J. M., Armbrust, E. V., Bachy, C., … & Worden, A. Z. (2017). Probing the evolution, ecology and physiology of marine protists using transcriptomics. Nature Reviews Microbiology, 15, 6-20. https://doi.org/10.1038/nrmicro.2016.160
source :
https://mythodologie.fr/articles/penser-avec-les-machines
IA – Les humanités à l’ère des LLM
En décembre 2025, SciencesPo s’est doté d’une doctrine sur l’usage des IA. À l’ère des grands modèles de langage, une illusion guette : confondre la fluidité du discours avec l’acte même de penser. Garance Benoît, professeure de philosophie, montre que la défense des humanités n’a rien de nostalgique : elles sont d’une frappante actualité.
Quand produire du texte ne suffit plus à penser
Parmi les manières récentes d’aborder la question de l’IA dans le discours public, il en est une ces derniers mois qui détonne, à laquelle Sciences Po participe largement, et qui consiste à dire que les larges modèles de langage (LLM) nous invitent dans la formation à revenir vers ce qu’on appelle « les humanités ». La réponse serait surprenante si elle consistait simplement à faire jouer un savoir traditionnel ancien contre une modernité dont les possibilités nous inquiètent. Elle s’entend mieux en revanche si l’on comprend qu’elle procède d’une réflexion sur la manière d’user au mieux de ces outils émergents, nous incitant à évaluer les possibilités ouvertes par ces programmes, mais aussi à estimer leurs limites.
Les LLM sont en effet aujourd’hui capables de produire, en quelques secondes, des résumés, des dissertations, des synthèses argumentées et des raisonnements plausibles. Cette capacité, désormais largement accessible, bouleverse les pratiques académiques et éducatives en rendant possible une production textuelle qui adopte jusqu’à un certain niveau les formes attendues du travail intellectuel. Il devient possible d’obtenir, sans engagement personnel réel, des textes structurés et cohérents, alors que ces productions étaient jusqu’alors associées à un travail de réflexion, de lecture et d’écriture. C’est ce fait, simple mais décisif, qui constitue le point de départ de beaucoup d’interrogations contemporaines autour des LLM, et qui nous invite à réfléchir à ce qui différencie la production et la lecture de textes humains par rapport à ceux générés artificiellement.
Un langage sans monde
Sans entrer dans des détails techniques inutilement complexes, rappelons quelques points sur le fonctionnement des LLM : ce sont des modèles statistiques entraînés à prédire la continuation la plus probable d’un énoncé (le prochain token) à partir de son contexte1. Et cela, ils le font en s’appuyant sur l’apprentissage de vastes corpus textuels, via ce qu’on appelle le « pré-entraînement » (qui constitue le fameux « P » de « GPT »). En se nourrissant ainsi de corpus immenses, ils condensent une part considérable de la culture écrite humaine. Dialoguer avec un tel modèle, ce n’est donc pas seulement interagir avec une machine, mais rencontrer une mémoire : une mémoire culturelle, impersonnelle, sédimentée, composée de textes, de styles, de raisonnements et de traditions intellectuelles accumulés au fil des siècles. Ce que le modèle mobilise, ce sont donc des formes héritées, des manières établies d’écrire et de penser, des régularités culturelles.
À ce titre, les LLM donnent accès à une puissance inédite d’exploration de la culture écrite. Ils recombinent, déplacent, rapprochent des éléments issus de traditions diverses, faisant apparaître des analogies et des continuités qui peuvent se révéler heuristiques. Cette capacité d’hybridation n’est d’ailleurs pas étrangère à la culture humaine elle-même : inventer n’a jamais signifié créer ex nihilo, mais toujours recomposer, transformer, recevoir et modifier des formes existantes. Une telle conception de la culture comme combinatoire a certainement trouvé son expression la plus célèbre dans la nouvelle La Bibliothèque de Babel de Borges. L’auteur y avait imaginé une bibliothèque infinie contenant toutes les combinaisons possibles de lettres, tous les textes possibles. En un sens, les larges modèles de langage réalisent à une échelle inédite quelque chose de proche : ils explorent un espace combinatoire, non pas infini et absurde, car il devait y avoir dans la bibliothèque imaginaire de Borges bien des ouvrages illisibles et dépourvus du moindre intérêt, mais structuré par les régularités statistiques des textes. Plutôt que de produire n’importe quelle combinaison, les LLM s’arrêtent sur celles qui sont rendues probables par les usages et les formes reconnues de la langue. En ce sens, ils réalisent une exploration de la culture écrite numérisée (dont il faudrait tout de même remarquer qu’elle n’en constitue qu’une partie) comme espace de possibles normés.
Cette puissance combinatoire des LLM donne des résultats tout à fait sidérants qui étonnent ses architectes eux-mêmes. Ingénieurs informatiques et mathématiciens sont, de leur propre aveu, incapables de dire pourquoi cela marche si bien. Puisque certaines productions générées par prompting avancé ou faites à partir de modèles spécifiques par fine-tuning miment nos ouvrages à s’y méprendre, il faut reconnaître que la production culturelle joue bien davantage encore que ce que nous pensions sur des mécanismes apparentés à la combinatoire.
Ceci étant posé, cette faculté rencontre néanmoins une limite décisive dans la création. Si la statistique permet de reproduire des normes, elle ne les institue pas. Les LLM suivent les régularités de ce qui a été dit, reconnu et stabilisé, sans pouvoir décider qu’une norme doit être déplacée ou abandonnée. C’est en ce sens que Kant, dans la Critique de la faculté de juger, distinguait d’ailleurs l’invention véritable de la simple reproduction. Ce qu’il appelait, selon un terme quelque peu passé de mode, le « génie » consistait précisément à instituer de nouveaux codes, donner ses règles à l’art, former de nouvelles écoles.
En réalité, si les LLM ne peuvent être créatifs au sens fort du terme, ce n’est pas une limite fortuite, mais structurelle. Les LLM produisent du contenu sans jamais être directement confrontés au monde au-delà de corpus linguistiques existants. Cela, nulle amélioration technique par Transformers, Chain-of-Thought, élargissement des data ou fine-tuning ne pourra le résoudre. Ils ne parlent jamais depuis une situation vécue à laquelle ils seraient exposés mais demeurent ce que le philosophe Hilary Putnam avait appelé dans une expérience de pensée des « cerveaux dans une cuve »2 : des systèmes de neurones capables de manipuler des représentations sans jamais pouvoir les rapporter à leurs conditions d’apparition.3
Or, écrire, parler, pour un sujet humain, ne consiste pas seulement à produire des énoncés cohérents ou plausibles. C’est toujours dire quelque chose de quelque chose, dans une situation déterminée. À l’inverse, les LLM parlent depuis des normes, mais sans exposition au réel qui pourrait troubler leur architecture, positivement ou négativement. Ils excellent alors dans l’exploration d’un espace de possibles déjà constitué, sans jamais pouvoir instituer de nouvelles formes.
Ce constat ne disqualifie pas l’usage des LLM comme outils. Il permet au contraire d’en préciser le statut. Les IA sont des dispositifs puissants de manipulation symbolique, capables de produire des analogies statistiques à une échelle inédite4. Mais ce qui fait la valeur d’une pensée, d’un jugement ou d’une œuvre, ne se laisse pas réduire à des combinaisons de langage, même immensément sophistiquées : cela demande une expérience du monde qui ne soit pas que linguistique et statistique.
Or, c’est ce manque du monde qui éclaire aujourd’hui, par contraste, la valeur des grands récits de vie et de voyage dans les œuvres humaines, de Thucydide à Nicolas Bouvier, en passant par Saint Augustin ou Marguerite Yourcenar. Ces récits témoignent d’un usage du monde irréductible à la seule médiation linguistique : ils engagent un corps, une temporalité, et une vulnérabilité à l’événement.
Et c’est à ce niveau que se joue finalement l’importance des œuvres humaines à l’ère des LLM. Elles nous apprennent d’une part que penser le monde suppose d’y avoir un rapport, donc de le parcourir ; et démontrent d’autre part que produire un discours n’est pas que la recombinaison de ce qui a déjà été dit.
Historiquement, ceci correspond à une fonction intellectuelle prise en charge par ce que l’on a appelé les « humanités ».
Ce que font les humanités
Pour parler de la pertinence des humanités dans le contexte actuel, il faut d’abord se mettre au clair sur ce qu’elles ont désigné historiquement, et ce en quoi elles sont encore actuelles pour une réflexion sur la formation des esprits. Notons qu’il ne s’agit pas ici d’en proposer une histoire exhaustive, mais de repérer succinctement, à travers quelques figures, les fonctions intellectuelles que ce terme recouvre.
Chez Cicéron, les humanitates désignent d’abord l’étude des lettres, de l’éloquence, et de la philosophie. Davantage qu’un ensemble disciplinaire, c’est surtout une pratique orientée vers le développement du jugement moral et l’aptitude à agir avec discernement dans la cité. C’est une éducation de l’homme libre, formé à la délibération et à la responsabilité publique. De là, on voit déjà que les humanités désignent au départ une ambition : celle d’élever l’homme, de l’orienter, de l’accompagner dans divers aspects de sa vie en formant son jugement.
À la Renaissance, les humanistes reprennent et transforment cet héritage à travers les studia humanitatis. Contre une scolastique tardive marquée par une lecture largement médiatisée des œuvres, filtrée par des chaînes de commentaires, ils promeuvent le retour aux textes eux-mêmes selon l’adage ad fontes : « retour aux sources ». Lire, interpréter, traduire les textes classiques deviennent alors des exercices centraux de l’éducation de l’homme. La situation n’est pas sans analogie avec le moment présent où la multiplication des résumés et des notes de synthèse produits par les LLM tendent à se substituer à la lecture des livres eux-mêmes. Dans ce contexte, il redevient pertinent de réaffirmer cette doctrine d’il y a cinq siècles : ad fontes, retournons à la lecture des grands textes, et prêtons attention à leur détail, à leur langage, et à la manière dont s’écrit une pensée.
Avec les Lumières enfin, et chez Kant en particulier, les humanités s’inscrivent dans une conception de la culture qui ne se définit pas par l’utilité immédiate, mais par le développement de l’usage libre et critique de la raison. Elles visent la formation d’un sujet autonome, capable de penser par lui-même et de se donner ses propres règles intellectuelles et morales. Cette injonction à l’élévation au-dessus de la simple utilité entre ici encore en résonance avec une problématique contemporaine : à mesure que les LLM produisent des textes formellement satisfaisants, ils mettent en lumière le fait que certaines pratiques — y compris dans un contexte scolaire et académique — reposaient déjà sur la reproduction de formes plutôt que sur l’exercice d’une pensée originale.
Ces figures permettent ainsi de dégager une constante : plus qu’à un ensemble de disciplines, les humanités désignent un certain type d’activité intellectuelle qui renvoie à des manières de lire, de juger et d’interpréter. Celles-ci engagent le sujet dans son rapport au sens et à la validité de ce qu’il affirme — une exigence pressante pour l’université contemporaine qui a pour tâche de former des esprits capables de répondre de leurs discours, dans un contexte où ceux-ci peuvent désormais être produits sans sujet.
Sur un malentendu contemporain : l’illusion des chaînes de pensée
Profitons enfin de cette discussion sur les spécificités de la parole humaine face à celle de l’IA pour aborder une confusion courante.
Le point classique de philosophie de l’esprit pour distinguer l’homme de la machine a consisté à dire que celle-ci pouvait bien mimer la compréhension humaine mais qu’elle n’aurait jamais accès à la compréhension ou à la « conscience » du contenu des énoncés qu’elle produit. Sur cette base, un contre-argument important a émergé dans les récents développements des LLM avec l’introduction de ce qu’on a appelé les « chaînes de pensée » (Chain-of-Thought), tendant à être intégrées systématiquement dans l’architecture des modèles depuis 2025. Plutôt que de produire directement une réponse finale, ces derniers sont programmés pour générer une succession d’étapes intermédiaires, formant un raisonnement explicité, dans le but d’améliorer leurs performances sur des tâches complexes. De là, certains observateurs contemporains ont proposé qu’il puisse s’agir d’une forme de raisonnement analogue à la réflexion humaine, au motif que ces séquences déploient une succession de moments logiquement articulés où le programme a accès à ses propres étapes de raisonnement, permettant de justifier pas à pas les réponses produites. Pourtant, l’analogie est trompeuse.
Sur ce point, il est en effet essentiel de distinguer deux choses : le raisonnement et la réflexion. Le raisonnement désigne un enchaînement d’énoncés selon des règles de cohérence ou d’inférence ; il peut être valide ou invalide, correct ou incorrect. La réflexion, en revanche, ne se réduit pas à cette continuité formelle.
Car qu’est-ce que réfléchir, au sens fort ? Telle que comprise par la tradition philosophique depuis Descartes, la réflexion humaine est une opération motivée par un doute. Réfléchir ne signifie pas simplement enchaîner des raisons ou produire des inférences. Le terme renvoie d’abord, par analogie avec la réflexion spéculaire en physique, à une interruption, puis au fait de s’éloigner un temps de l’objet sur lequel on a buté pour revenir à soi. Ainsi, le Penseur de Rodin médite assis, immobile. De même, dans le tableau La Pensée de Jean Despuljols, on observe une lectrice, l’index de la main arrêté sur la ligne d’un livre ouvert sur ses genoux, le regard levé, perdu dans un trouble. Réfléchir, c’est donc d’abord suspendre son action, sa lecture, le fil habituel de sa pensée, afin de s’attarder sur ce qui résiste. Cette suspension suppose du temps, une distance et un effort.
À l’inverse, les chaînes des LLM sont continues et non vécues. Elles ressemblent à des réflexions, mais sans intuition originaire, sans interruption, et sans doute. Elles enchaînent des réponses plausibles sans que rien ne fasse véritablement problème pour elles, et sans assumer de responsabilité énonciative (ce dont ses multiples erreurs, qu’on appelle les « hallucinations » sont le symptôme). Si la pensée humaine peut se tromper, hésiter et s’égarer, elle sait aussi douter, s’arrêter et revenir sur ce qu’elle affirme. C’est cette conscience de l’exposition à l’erreur qui fonde en dernière instance la réflexion.
Mal employés, les LLM tendent à court-circuiter le moment de suspension face à un problème, où la réflexion devrait naître. Déléguer une difficulté à un programme sans s’y être d’abord confronté, c’est ainsi se dispenser de ce passage à la réflexion que l’expérience du monde rend possible. Le risque — déjà largement rencontré dans l’enseignement auprès des élèves — est alors que l’IA devienne un automatisme qui prenne la place de la pensée.
Garance Benoît
Notes :
1. Alors que les modèles antérieurs traitaient le langage séquentiellement, mot après mot, la révolution des Transformers permet de considérer l’ensemble d’une phrase simultanément.
2. Dans Reason, Truth and History (1981), Hilary Putnam soutient que le sens et la référence ne peuvent être entièrement internes à l’esprit : un sujet privé de tout contact causal avec le monde ne pourrait pas réellement y référer. Cette thèse, qu’il nomme « externalisme sémantique », affirme ainsi que la signification dépend non seulement du langage, mais aussi d’un rapport effectif au monde extérieur.
3. La position de Yann LeCun, considéré comme l’un des inventeurs de l’apprentissage profond, offre à cet égard une critique éclairante. En annonçant le 19 novembre 2025 son départ de Meta dont il assurait la direction scientifique de l’IA pour fonder une start-up dédiée à des systèmes capables de « comprendre le monde physique », il a vivement critiqué une industrie trop centrée sur les seuls modèles de langage. Il plaide depuis pour des modèles fondés sur la perception et l’action, c’est-à-dire dotés d’un rapport matériel au monde.
4. On en voit une illustration dans le recours croissant aux méthodes de machine learning dans des disciplines fondées sur l’exploitation massive de données, comme l’astrophysique ou la cosmologie. Ces outils permettent d’améliorer les prédictions et d’extraire des informations à partir de corrélations complexes. Mais, comme le rappellent les physiciens eux-mêmes, cette efficacité prédictive ne saurait être confondue avec une compréhension des lois et des principes fondamentaux qui gouvernent les phénomènes étudiés.
source :
Laisser un commentaire